KI-Lippensynchronisation mit OmniHuman v1.5: audiogesteuerte Avatare
Ein technischer Einblick in die Lippensynchronisationstechnologie von OmniHuman v1.5. Erfahre, wie Phonemextraktion, Visem-Mapping und zeitliche Ausrichtung zusammenwirken, um eine framegenaue Lippensynchronisation für KI-Avatarvideos zu erzeugen.
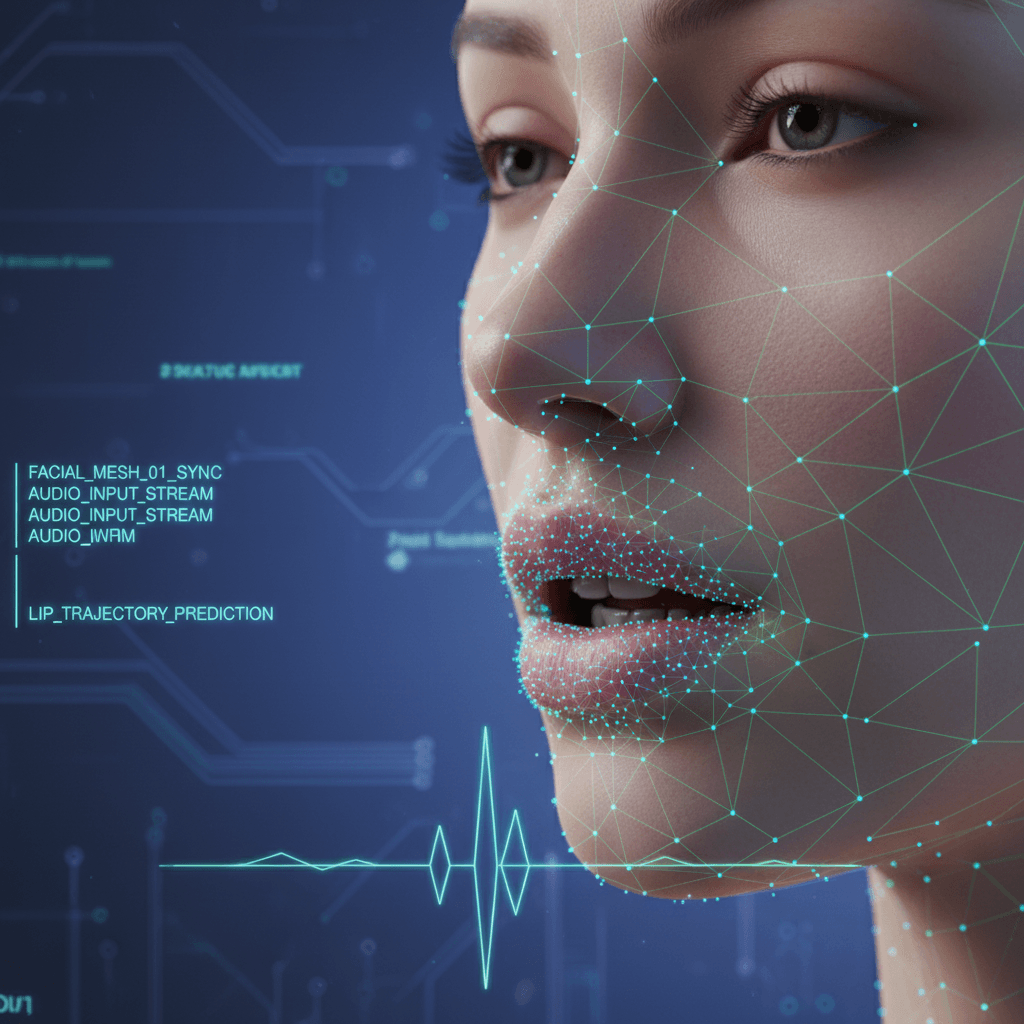
Die meisten KI-Avatare scheitern am Lippensynchron-Test innerhalb von drei Sekunden: Münder öffnen und schließen sich grob im Takt der Audioausgabe, aber die spezifischen Formen passen nicht zu den tatsächlich gesprochenen Lauten. OmniHuman v1.5 schließt diese Lücke, indem es Phoneme - die kleinsten Einheiten der Sprache - auf präzise Mundkonfigurationen in jedem einzelnen Frame abbildet. So entsteht eine Lippensynchronisation, die auch dann standhält, wenn Zuschauer genau hinsehen und den Ton eingeschaltet haben.
Kurzfassung
- OmniHuman v1.5 verwendet Lippensync auf Phonemebene, nicht nur timingbasierte Mundanimation
- Das Modell extrahiert Sprachlaute aus dem Audio und ordnet sie Visemen (Mundformen) zu
- Saubere Audioeingabe verbessert die Synchronisationsgenauigkeit erheblich
- Ein 30-sekündiges lippensynchrones Video kostet 7,20 Dollar (72 Credits) in Plänen ab 5 Dollar pro Monat
- Funktioniert in jeder gesprochenen Sprache mit ausreichender Trainingsrepräsentation
Warum die meisten KI-Lippensynchronisationen unzureichend sind
Herkömmliche Avatar-Tools verwenden typischerweise eine von zwei Abkürzungen:
Rein timingbasierte Animation. Der Mund öffnet und schließt sich basierend auf den Lautstärkepeaks des Audios. Laute Momente = geöffneter Mund, leise Momente = geschlossener Mund. Das wirkt aus der Distanz akzeptabel, scheitert aber sofort bei näherer Betrachtung, weil die spezifischen Formen falsch sind.
Festes Viseme-Cycling. Eine kleine Bibliothek generischer Mundformen läuft in Reaktion auf breite Sprachkategorien in Schleifen. Das ist besser als rein lautstärkegesteuerte Animation, verfehlt aber dennoch die feinen Unterschiede zwischen ähnlichen Lauten.
Das Ergebnis ist in beiden Fällen das "Uncanny Valley der Mundbewegung" - etwas, das fast real wirkt, aber für jeden aufmerksamen Betrachter klar synthetisch ist.
Jetzt einen KI-Moderator erstellen
Verwandle ein Foto und Audio in ein lebensechtes Sprechvideo. 7,20 Dollar pro 30-Sekunden-Video in Plänen ab 5 Dollar pro Monat.
OmniHuman kostenlos testen5 kostenlose Generierungen · Keine Kreditkarte erforderlich
Was OmniHuman v1.5 anders macht
OmniHuman v1.5 behandelt Lippensync als strukturiertes Problem der Sprache-zu-Form-Zuordnung. Die Pipeline läuft in vier Stufen ab.
Stufe 1: Phonemextraktion
Das Audio wird durch ein akustisches Modell geleitet, das einzelne Phoneme identifiziert - die kleinsten Einheiten unterschiedlicher Laute in der gesprochenen Sprache. Englisch hat etwa 44 Phoneme. Spanisch hat etwa 24. Mandarin hat wiederum einen anderen Satz. Das Modell erkennt Phoneme mit einer Zeitgenauigkeit von einer Millisekunde.
Stufe 2: Visem-Mapping
Jedes Phonem wird einem oder mehreren Visemen zugeordnet - visuell unterschiedlichen Mundformen. Ein Visem für "/p/" zeigt den Lippenverschluss vor der Freigabe. Ein Visem für "/f/" zeigt die oberen Zähne auf der Unterlippe. Ein Visem für "/o/" zeigt einen gerundeten, geöffneten Mund. Die Phonem-zu-Visem-Zuordnung ist sprachbewusst und berücksichtigt den Kontext.
Stufe 3: Zeitliche Ausrichtung
Viseme werden anhand des Phonem-Timings bestimmten Video-Frames zugeordnet. Bei 30 Frames pro Sekunde erhält jeder Frame die Mundform, die dem genauen Audioausschnitt entspricht, den er repräsentiert. Übergänge zwischen Visemen werden geglättet, um ruckartige Mundbewegungen zu vermeiden.
Stufe 4: Diffusions-Rendering
Die abschließende Rendering-Stufe generiert die eigentlichen Pixel und kombiniert die Visem-Informationen mit Identitätsmerkmalen aus dem Referenzfoto, prosodie-gesteuertem Gesichtsausdruck und dem Szenen-Prompt. Der Mund wird nicht "aufgeklebt" - er wird als Teil jedes einzelnen Frames generiert.
Warum das für Zuschauer wichtig ist
So sieht Lippensync auf Phonemebene in der Praxis aus, wenn man auf spezifische Laute achtet.
Plosive (p, b, t, d, k, g): Lippen- oder Zungenverschluss vor dem Laut, dann Freigabe. OmniHuman zeigt den Verschluss deutlich.
Frikative (f, v, s, z, sch, th): Luft fließt durch eine verengte Stelle. "F" und "V" erfordern obere Zähne auf der Unterlippe, was OmniHuman präzise wiedergibt.
Vokale (a, e, i, o, u): Unterschiedliche Grade der Kieferöffnung und Lippenrundung. "Oh" und "Ah" sehen unterschiedlich aus, wie es sein sollte.
Diphthonge (oi, ou, ay): Gleitende Übergänge zwischen zwei Vokalformen. Das Modell rendert die Bewegung gleichmäßig über die Frames.
Nasale (m, n, ng): Geschlossener oder fast geschlossener Mund mit Luftstrom durch die Nase. Der subtile Unterschied zwischen "m" (Lippen geschlossen) und "n" (Zunge am Alveolarkamm) zeigt sich durch leichte Kieferpositionierung.
Wenn all das korrekt gehandhabt wird, fällt die Lippensynchronisation überhaupt nicht mehr auf. Das ist das Ziel - Unsichtbarkeit.
So erzielt man den besten Lippensync
Die Qualität der Audioeingabe ist der mit Abstand wichtigste Faktor für die Genauigkeit der Lippensynchronisation. So lässt sie sich optimieren.
Saubere, isolierte Sprache verwenden
Musik, Hintergrundgespräche, starkes Umgebungsrauschen und Raumhall stören die Phonemextraktion. Vor dem Hochladen des Audios:
- Musik oder Soundeffekte entfernen oder absenken
- In einem ruhigen Raum aufnehmen oder ein Noise-Gate verwenden
- Räume mit starkem Echo vermeiden
- Keine Effekte wie starke Kompression oder EQ einbacken
Auf professionelle Aufnahmequalität achten
Ein Broadcast-Studio ist nicht nötig, aber ein USB-Kondensatormikrofon in einem ruhigen Raum übertrifft ein Laptop-Mikrofon jedes Mal. Zielwerte:
- Abtastrate von 44,1 kHz oder 48 kHz
- 16-Bit- oder 24-Bit-Tiefe
- Mono oder Stereo beide akzeptabel
- Pegelspitzen um -3 dB, kein Clipping
In natürlichem Tempo sprechen
Gehetztes oder monotones Sprechen erzeugt einen weniger überzeugenden Lippensync als eine natürliche, abwechslungsreiche Aussprache. Sprechen Sie so, wie Sie es in einem echten Gespräch tun würden, mit natürlichen Pausen und Betonungen.
Führende und abschließende Stille kürzen
OmniHuman generiert Video für die gesamte Audiodauer. Wenn das Audio mit 3 Sekunden Stille beginnt, werden Frames verschwendet. Möglichst knapp zuschneiden.
Innerhalb der Dauerbegrenzungen bleiben
OmniHuman v1.5 unterstützt bis zu 60 Sekunden bei 720p und 30 Sekunden bei 1080p. Clips nahe der Obergrenze zeigen manchmal Qualitätseinbußen bei den letzten Frames. Eine oder zwei Sekunden unter dem Limit bleiben.
OmniHuman v1.5 ausprobieren? Kostenlos loslegen →

Einen solchen Moderator gewünscht? OmniHuman kostenlos ausprobieren →
Sprachspezifische Besonderheiten
Phonemsätze unterscheiden sich zwischen Sprachen, und die Genauigkeit des Modells variiert je nach Repräsentation in den Trainingsdaten.
Umfangreich trainierte Sprachen
Englisch, Mandarin, Spanisch, Portugiesisch, Französisch, Deutsch, Japanisch und Koreanisch erhalten hochgenauen Lippensync. Diese Sprachen verfügen über umfangreiche Trainingsdaten, und Phoneme werden mit Frame-genauer Präzision auf Viseme abgebildet.
Gut unterstützte Sprachen
Italienisch, Russisch, Arabisch, Hindi, Indonesisch, Vietnamesisch und Türkisch funktionieren zuverlässig mit guter Lippensync-Qualität. Leichte Variationen bei regionalen Akzenten können einzelne Phoneme geringfügig beeinflussen.
Aufkommende Sprachunterstützung
Weniger verbreitete Sprachen funktionieren, aber die Genauigkeit bei seltenen Phonemen kann geringer sein. Mit einer kurzen Probe testen, bevor man sich auf eine große Produktion einlässt.
Bei mehrsprachigen Projekten siehe mehrsprachiger Leitfaden für Empfehlungen zu Stimmen und Lokalisierungs-Workflows.
Häufige Lippensync-Probleme und ihre Lösung
Mundbewegungen wirken leicht verzögert
Ursache: Die Audiodatei hat am Anfang stille Abschnitte, oder Kompressionsartefakte haben das Phonem-Timing verschoben. Lösung: Führende Stille kürzen, mit höherer Bitrate neu exportieren (MP3 192kbps oder höher, oder WAV).
Mundformen wirken zu generisch
Ursache: Audio ist rauschbehaftet oder undeutlich, was die Phonemextraktion beeinträchtigt. Lösung: In einem ruhigeren Raum neu aufnehmen oder das Audio durch ein Rauschunterdrückungs-Tool leiten.
Synchronisation funktioniert bei Vokalen, aber Konsonanten wirken weich
Ursache: Schlechtes Mikrofon oder starke Kompression dämpft die Transienten der Konsonanten. Lösung: Besseres Mikrofon verwenden, Kompression reduzieren oder TTS verwenden, das sauberere Konsonanten erzeugt.
Lippensync bricht bei bestimmten Akzenten zusammen
Ursache: Regionale Akzent-Phonemvarianten sind in den Trainingsdaten möglicherweise unterrepräsentiert. Lösung: Eine neutrale Akzentstimme für dieselbe Sprache ausprobieren oder professionelles TTS mit auswählbaren Regionalstimmen verwenden.
Synchronisation driftet bei längeren Clips
Ursache: Audio-Uhr und Video-Uhr geraten am Ende langer Dauern außer Takt. Lösung: Eine oder zwei Sekunden unter der Dauerobergrenze bleiben. Längere Inhalte in Segmente aufteilen.
Lippensync-Qualität testen
Bevor man sich auf einen langen Produktionslauf einlässt, sollte man mit einer kurzen Probe testen.
Der 10-Sekunden-Test
- Einen 10-sekündigen Audioclip mit diesem genauen Satz aufnehmen: "Peter picked pepper, five fish fried, shy shepherds sigh."
- Mit dem gewählten Referenzfoto zu OmniHuman v1.5 hochladen
- Generieren und in 100 % Größe abspielen
- Achten auf:
- Deutlichen Lippenverschluss bei "P"-Lauten
- Obere Zähne auf der Unterlippe bei "F"
- Unterschiedliche Mundformen bei "sh" und "s"
- Saubere Übergänge zwischen Phonemen
Wenn der 10-Sekunden-Test sauber aussieht, wird auch die 30-60-sekündige Produktion sauber aussehen.
Direktvergleich
OmniHuman-Ausgabe neben dem Referenzaudio mit Kopfhörern abspielen. Augen schließen, dann öffnen. Wenn die Mundbewegungen beim erneuten Fokussieren auf das Video "offensichtlich" wirken, funktioniert die Synchronisation. Wenn sie "falsch" wirken, muss etwas in der Audio-Pipeline überarbeitet werden.
Wie Lippensync in die vollständige Generierungs-Pipeline passt
Lippensync ist eines von mehreren parallelen Systemen, die während der OmniHuman-Generierung laufen. Die vollständige Pipeline umfasst:
- Identitätserhaltung aus dem Referenzfoto
- Gesichtsausdruck, gesteuert durch Audioemotion und Prosodie
- Kopfbewegung, die mit dem Sprachrhythmus korreliert
- Schulter- und Oberkörpergesten, synchronisiert mit Betonungen
- Hintergrund- und Szenen-Rendering aus dem Prompt
- Zeitliche Kohärenz über Frames hinweg
Lippensync existiert nicht isoliert - er ist eine Ebene eines größeren generativen Systems. Wenn alles zusammenwirkt, sehen Zuschauer eine natürliche Aufnahme und keinen sprechenden Kopf mit guter Mundbewegung.
Den vollständigen technischen Überblick finden Sie unter vollständiger OmniHuman v1.5-Leitfaden.
Phonemgenaue Synchronisation, 7,20 Dollar für 30 Sekunden
Keine Sync-Qualitätsstufen und keine Preisgestaltung pro Nutzer. Ein Preis pro Video, und die monatlichen Credits werden mit jedem Abrechnungszyklus erneuert.
Synchronisation testenKosten und Zugang
Jede OmniHuman v1.5-Generierung - einschließlich Lippensync - kostet 3-72 Credits ($0,30-$7,20), was sich nach der Länge des Audios richtet: 2,4 Credits pro Sekunde. Kein Aufpreis für Lippensync, keine abgestuften Sync-Qualitäten. Bei jedem Rendering erhält man dieselbe Genauigkeit auf Phonemebene.
Neue Arteza-Konten erhalten 10 Gratis-Credits bei der Anmeldung. Der 5-Dollar-Starter-Plan bietet 60 Credits pro Monat, genug für eine dreißigsekündige Generierung plus Ausprobieren. Vollständige Details finden Sie unter Preisleitfaden.
Lippensync-Qualität testen
- Bei Arteza anmelden und 10 Gratis-Credits sichern
- Den 5-Dollar-Starter-Plan abonnieren
- Einen kurzen Zungenbrecher-Audioclip und ein Porträtfoto vorbereiten
- OmniHuman v1.5 öffnen
- Generieren und auswerten
Für mehr Kontext siehe vollständiger OmniHuman v1.5-Leitfaden, Tutorial für sprechende Köpfe und mehrsprachiger Leitfaden.
OmniHuman v1.5 ausprobieren? Kostenlos loslegen →
OmniHuman v1.5 ausprobieren - Jetzt!
Laden Sie Ihr Referenzbild auf der Erstellungsseite hoch.
5 kostenlose Generierungen · Keine Kreditkarte erforderlich