このアプリで作成
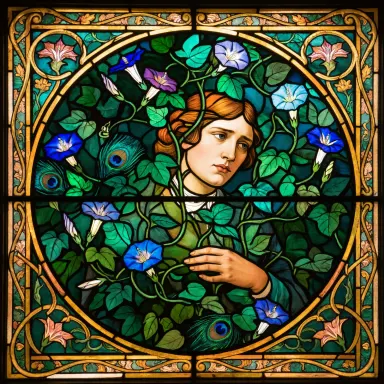
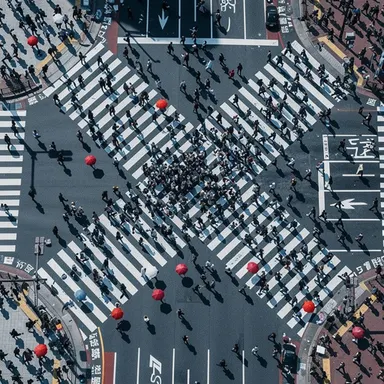
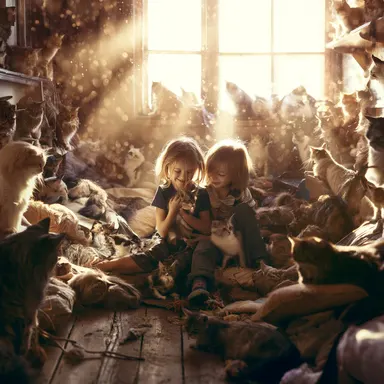
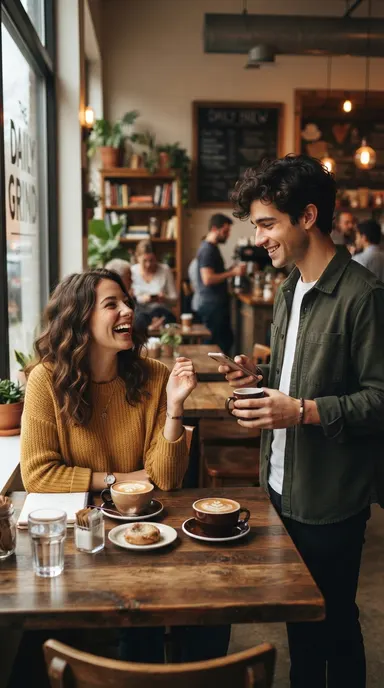
このアプリは、OpenAIのGPT Image 1をArtezaのクリエイティブスタジオに統合し、正確な指示理解、反復的な画像編集、複雑なマルチステッププロンプトのサポートを中心とするテキスト・ツー・イメージ生成を提供します。詳細な指示や段階的な指示を正確に解釈する必要があるデザイナー、マーケター、コンテンツクリエイターに最適で、一般的な結果ではなく求めた通りの画像を生成します。連続した編集でシーンを洗練させる場合でも、複数の特定の制約条件を持つ構図を説明する場合でも、GPT Image 1はこれらの要件を幅広い視覚スタイルにわたって追跡し、実行するために設計されています。
このアプリの使い方
- 1
作成したいものを説明するか、ソースファイルをアップロードしてください。
- 2
オプションを選択して、「生成」を押してください。
- 3
数秒でギャラリーに結果が表示されます。
- 4
ダウンロード、シェア、または新しいアイデアで再度生成できます。
作成できるもの
詳細なシーン構成
プロンプトが特定のライティング、指定されたアートスタイル、特定の被写体配置、背景の詳細など複数の制約条件を同時に必要とする場合、GPT Image 1はこれらすべての指示をまとめて保持します。長い段階的なブリーフを日常的に作成し、要素が落とされないモデルを必要とするクリエイティブディレクターに最適です。
反復的な画像編集
編集がネイティブサポートされているため、ベース画像を生成してから、色の調整、オブジェクトの交換、背景の変更、顔の表情の微調整など、フォローアップ指示を送信して最初からやり直す必要がありません。このループにより、製品モックアップやソーシャルアセットの修正時間を大幅に短縮できます。
マルチスタイルコンセプト探索
GPT Image 1は多彩なスタイルに対応しているため、ブランドチームは同じキャンペーンコンセプトをフラットイラスト、フォトリアリスティックシーン、ヴィンテージポスターとして順番にレンダリングしてテストできます。各リクエストは共有コンセプトに忠実に従いながら、指定したスタイリストパラメータのみを変更します。
画像内の正確なテキストとレイアウト
強力な指示理解により、このモデルは読みやすいラベル、看板、またはテキストオーバーレイを記述通りの位置に含む画像生成に適しています。パッケージングモックアップ、店舗ビジュアル、イベントチラシは、位置情報と字幕指示を確実な要件として扱うモデルから恩恵を受けます。
ステップバイステップのビジュアルストーリーテリング
マルチステッププロンプトサポートにより、一貫した登場人物の詳細と設定線索を1フレームから次のフレームに引き継ぎながら、ビジュアルナレーティブをパネルごとに構築できます。イラストレーターとストーリーボードアーティストは、毎回シーン全体を書き直すのではなく、増分的な変更を加えて各場面を説明できます。
試すプロンプトのアイデア
クリエイターがこのアプリを使う理由
- 強力な指示遵守
- 画像編集
- 多目的なスタイル
- マルチステップ
より良い結果のためのヒント
制約条件を最初に述べる
GPT Image 1は指示理解のために構築されているため、最も重要な要件をプロンプトの始まりに配置します。主題、スタイル、ライティング、構図を二次的な詳細の前に記述します。モデルは詳細を適切に追跡しますが、優先事項を先に示すことで、モデルはそれらを正しく重み付けするのに役立ちます。
再プロンプトの代わりに編集を使用する
編集がサポートされているため、結果がほぼ正確だが完全ではない場合は、全く新しいプロンプトを書く衝動に抵抗します。変更すべき内容のみを説明する対象を絞った編集指示を送信します。これにより既に機能しているものが保持され、画像全体での意図しない変動の導入を回避します。
スタイル参照を明示的に指定する
多彩なスタイルは、モデルが曖昧なスタイル手掛かりを緩く解釈することを意味します。フラットベクトル、油絵、アイソメトリックピクセルアート、またはエディトリアルフォトグラフィなど、スタイルカテゴリを正確に命名して、モデルが意図しなかった影響をブレンドするのではなく、1つの方向に確実に進むようにします。
複雑なシーンをステップに分ける
マルチステッププロンプトサポートは、ここでは真の機能です。最終画像に多くの動く部分がある場合は、まずコアシーンを説明し、生成してから、フォローアッププロンプトを通じてレイヤーを追加します。このステージング方法により、チェックポイントが提供され、モデルが長い単一プロンプトを誤解する可能性が低減されます。
このアプリを選ぶべき場面
詳細な指示への正確な準拠、セッション内での画像編集、または複数の要件をチェーンするプロンプトが必要な場合は、Seedream v3またはFLUX.1 Schnellよりもこのアプリを選択してください。それらのモデルは速度またはスタイリスティック出力を優先するのに対し、GPT Image 1は精度と反復的な制御に最適化されているため、生の生成ペースよりもブリーフの詳細が重要な場合に適切なツールです。
よくある質問
このアプリでの編集サポートとは具体的には何を意味しますか?
画像生成後、オブジェクトの交換、色の調整、背景の変更など、何を変更するかを説明するフォローアップテキスト指示を送信できます。GPT Image 1は構成の残りの部分を保持しながら編集を適用するため、詳細を調整する必要があるたびに最初から再生成する必要がありません。
プロンプトはどのくらい長く、詳細にできますか?
GPT Image 1は複雑なマルチステッププロンプトのために特別に構築されているため、複数のシーン制約、スタイリストパラメータ、構成方向、二次的な詳細を単一プロンプトに含めることができます。モデルは最も明白な解釈に削減するのではなく、層状の指示を追跡して尊重するために設計されています。
このアプリはどのビジュアルスタイルをうまく処理しますか?
モデルはフォトリアリスティック、フラットイラスト、ベクトル、絵画的、ビンテージ、アイソメトリック、エディトリアルを含む多彩なスタイルをカバーしています。「モダン」や「アーティスティック」のような曖昧な表現を使うよりも、プロンプトでスタイル名を明確に指定する方が、モデルが指定カテゴリをより正確に再現し、一貫した結果が得られます。
このアプリは読可能なテキストを含む画像の生成に適していますか?
はい。GPT Image 1は強力な指示理解のおかげで、多くの生成モデルよりも画像内のテキストをより信頼できく処理します。看板、ラベル、ポスタータイポグラフィ、およびプロンプトで説明されている短いフレーズは、このモデルが美的出力に純粋に焦点を当てた代替品よりもパフォーマンスが優れている領域です。
同じセッション内で複数の生成にわたって一貫性を保つことができますか?
各フォローアッププロンプトで前の結果を参照し、何が変わらないままであるべきかについて明示することで、詳細を前に進めることができます。モデルは文字またはシーンデータを自動的にロックしませんが、その指示理解強度は、一貫したテキスト説明が連続した生成全体で主要要素を確実に再現することを意味します。
このアプリに適さないプロジェクトの種類は何ですか?
最高の出力解像度が必要な場合、または命令精度よりも生の美的品質を優先している場合は、Seedream 5.0 Proなどのシスターアプリがより役立つ可能性があります。このアプリは、プロンプトを緩く解釈して印象的にレンダリングされた画像を生成するのではなく、説明通りに実行することに優れています。
このアプリはどのAIモデルで動作していますか?
このアプリはGPT Image 1で動作し、Artezaを通じて利用でき、別のアカウントやセットアップは不要です。
生成した結果を商用利用できますか?
はい。生成したコンテンツはご自身でご利用いただけます。当社のコンテンツライセンスに従ってください。
生成にはどのくらい時間がかかりますか?
ほとんどの生成は1分以内に完了し、ギャラリーでリアルタイムで進捗を確認できます。