API OmniHuman v1.5: generazione programmatica di video con avatar
Una guida per sviluppatori all'API OmniHuman v1.5 su Arteza. Scopri la struttura degli endpoint, l'autenticazione, i parametri delle richieste, la gestione delle risposte, l'integrazione dei webhook e le best practice per costruire flussi di lavoro automatizzati per video con avatar.
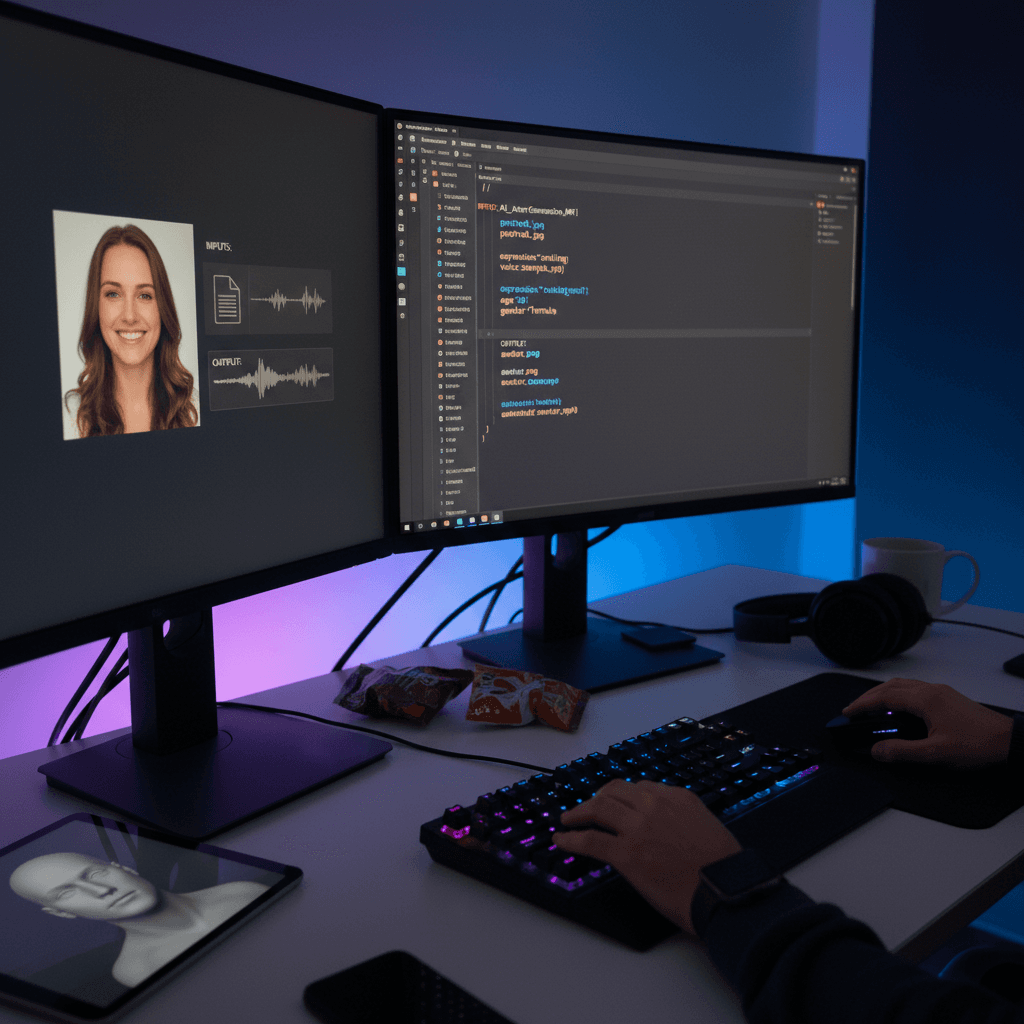
Utilizzare OmniHuman v1.5 tramite l'interfaccia di Arteza è ideale per creazioni occasionali. Per flussi di lavoro ad alto volume, come outreach di vendita personalizzato, lanci multilingue, generazione video guidata da CMS e digest di notizie automatizzati, conviene usare l'API. Questa guida illustra autenticazione, endpoint, struttura delle richieste, gestione dei webhook e pattern di produzione. Ogni generazione costa 3-72 crediti ($0,30-$7,20), sia che venga avviata tramite interfaccia grafica sia tramite API.
Sintesi
- Genera video OmniHuman v1.5 in modo programmatico tramite l'API REST di Arteza
- Stesso prezzo di $0,30-$7,20 per generazione dell'interfaccia grafica, senza sovrapprezzo API
- Generazione asincrona con recupero dei risultati tramite webhook o polling
- Ideale per video di vendita personalizzati, librerie di formazione automatizzate e lanci multilingue
- Autenticazione tramite chiave API dal tuo dashboard Arteza
Perché usare l'API
L'API sblocca pattern di automazione che l'interfaccia grafica non può eguagliare:
- Generazione in batch. Esegui 100 o più video in un unico ciclo di pipeline.
- Personalizzazione dinamica. Recupera dati da un CRM e genera un video per ogni prospect.
- Flussi di lavoro pianificati. Digest di notizie giornalieri, video riassuntivi settimanali, aggiornamenti su trigger.
- Integrazione con stack esistenti. Node.js, Python, Go, Ruby: qualsiasi linguaggio con HTTP può effettuare chiamate.
- Produzione riproducibile. Script sotto controllo di versione invece di clic manuali sull'interfaccia.
Se il tuo caso d'uso prevede più di 10 video con struttura simile, vale la pena configurare l'API.
Crea subito il tuo presentatore AI
Trasforma una foto e un audio in un video parlante realistico. $7,20 per video da 30 secondi con piani a partire da $5 al mese.
Prova OmniHuman gratis5 generazioni gratuite · Nessuna carta di credito richiesta
Autenticazione
Le richieste all'API di Arteza si autenticano tramite una chiave API passata nell'intestazione Authorization come token Bearer.
Ottenere la chiave API
- Accedi su arteza.ai
- Vai alle impostazioni del tuo account
- Trova la sezione API
- Genera una nuova chiave API
- Conservala in modo sicuro: trattala come una password
Non inserire mai la chiave API nel controllo di versione. Usa le variabili d'ambiente:
export SEEDANCE_API_KEY="your_api_key_here"
Intestazione di autenticazione
Ogni richiesta include:
Authorization: Bearer YOUR_SEEDANCE_API_KEY
Content-Type: application/json
Struttura degli endpoint
L'API di OmniHuman v1.5 segue i pattern standard di generazione asincrona:
- POST per creare un job di generazione
- GET per verificare lo stato e i risultati tramite polling
- Webhook per la consegna asincrona (consigliato per la produzione)
URL di base
https://api.arteza.ai/v1
Endpoint principali
| Metodo | Percorso | Scopo |
|---|---|---|
POST | /omnihuman/generate | Invia un nuovo job di generazione |
GET | /jobs/{job_id} | Controlla lo stato e il risultato del job tramite polling |
POST | /webhooks | Configura gli endpoint webhook |
Consulta la documentazione API live di Arteza per i percorsi esatti degli endpoint, che possono evolvere nel tempo.
Invio di un job di generazione
Struttura della richiesta
{
  "model": "omnihuman-v1.5",
  "image_url": "https://example.com/portrait.jpg",
  "audio_url": "https://example.com/speech.mp3",
  "prompt": "Modern corporate office with soft natural lighting, medium close-up framing head and shoulders, professional broadcast style",
  "resolution": "1080p",
  "turbo_mode": false,
  "webhook_url": "https://yourapp.com/webhooks/seedance"
}
Riferimento ai parametri
| Parametro | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
model | string | Sì | Deve essere "omnihuman-v1.5" |
image_url | string | Sì | URL pubblicamente accessibile al ritratto di riferimento |
audio_url | string | Sì | URL pubblicamente accessibile al file audio |
prompt | string | Sì | Descrizione della scena per sfondo, illuminazione e inquadratura |
resolution | string | No | "720p" oppure "1080p" (predefinito: "720p") |
turbo_mode | boolean | No | Abilita la generazione più rapida (predefinito: false) |
webhook_url | string | No | URL che riceve la notifica di completamento asincrono |
Requisiti dei file di input
Immagine:
- Formati: JPEG, PNG
- Risoluzione: minimo 512x512, consigliato 1024x1024 o superiore
- Accessibile tramite URL HTTPS pubblico
Audio:
- Formati: MP3, WAV, M4A
- Durata: ≤60s per 720p, ≤30s per 1080p
- Accessibile tramite URL HTTPS pubblico
Se i tuoi file non sono già ospitati pubblicamente, caricali su S3, Cloudflare R2, Google Cloud Storage o servizi simili prima di effettuare la chiamata API.
Esempio di richiesta in Python
import os
import requests

SEEDANCE_API_KEY = os.environ["SEEDANCE_API_KEY"]
BASE_URL = "https://api.arteza.ai/v1"

def create_omnihuman_video(image_url, audio_url, prompt,
                           resolution="1080p", turbo=False):
    headers = {
        "Authorization": f"Bearer {SEEDANCE_API_KEY}",
        "Content-Type": "application/json",
    }
    payload = {
        "model": "omnihuman-v1.5",
        "image_url": image_url,
        "audio_url": audio_url,
        "prompt": prompt,
        "resolution": resolution,
        "turbo_mode": turbo,
    }
    response = requests.post(
        f"{BASE_URL}/omnihuman/generate",
        json=payload,
        headers=headers,
    )
    response.raise_for_status()
    return response.json()

job = create_omnihuman_video(
    image_url="https://cdn.example.com/ceo.jpg",
    audio_url="https://cdn.example.com/weekly-update.mp3",
    prompt="Corporate office with warm lighting, medium close-up, professional style",
)
print(f"Job inviato: {job['job_id']}")
Esempio di richiesta in Node.js
import fetch from "node-fetch";

const SEEDANCE_API_KEY = process.env.SEEDANCE_API_KEY;
const BASE_URL = "https://api.arteza.ai/v1";

async function createOmnihumanVideo({
  imageUrl,
  audioUrl,
  prompt,
  resolution = "1080p",
  turbo = false,
}) {
  const response = await fetch(`${BASE_URL}/omnihuman/generate`, {
    method: "POST",
    headers: {
      Authorization: `Bearer ${SEEDANCE_API_KEY}`,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({
      model: "omnihuman-v1.5",
      image_url: imageUrl,
      audio_url: audioUrl,
      prompt,
      resolution,
      turbo_mode: turbo,
    }),
  });

  if (!response.ok) {
    throw new Error(`Errore API Arteza: ${response.status}`);
  }
  return response.json();
}

const job = await createOmnihumanVideo({
  imageUrl: "https://cdn.example.com/ceo.jpg",
  audioUrl: "https://cdn.example.com/update.mp3",
  prompt: "Modern office, soft lighting, medium close-up",
});
console.log(`Job inviato: ${job.job_id}`);
Formato della risposta
{
  "job_id": "job_abc123xyz",
  "status": "queued",
  "created_at": "2026-04-10T14:23:00Z",
  "estimated_credits": 46
}
Il job_id è quello che utilizzi per il polling o per correlare le consegne dei webhook.
Polling per i risultati
Se non stai usando i webhook, esegui il polling dell'endpoint di stato del job finché non è completato.
import time

def wait_for_video(job_id, timeout_seconds=600, poll_interval=5):
    headers = {"Authorization": f"Bearer {SEEDANCE_API_KEY}"}
    deadline = time.time() + timeout_seconds

    while time.time() < deadline:
        response = requests.get(
            f"{BASE_URL}/jobs/{job_id}",
            headers=headers,
        )
        response.raise_for_status()
        data = response.json()
        status = data["status"]

        if status == "completed":
            return data["result"]["video_url"]
        if status == "failed":
            raise Exception(f"Generazione fallita: {data.get('error')}")

        time.sleep(poll_interval)

    raise TimeoutError("Il job non ha completato entro il timeout")

video_url = wait_for_video(job["job_id"])
print(f"Video pronto: {video_url}")
Valori dello stato del job
| Stato | Significato |
|---|---|
queued | In attesa di avvio |
processing | Generazione in corso |
completed | Video pronto, URL disponibile |
failed | Generazione fallita, controlla il campo errore |
Utilizzo dei webhook (consigliato per la produzione)
I webhook eliminano il polling e ti permettono di costruire pipeline event-driven.
Configurazione di un webhook
Passa webhook_url nella tua richiesta di generazione. Seedance effettua una POST a quell'URL quando il job è completato.
Payload del webhook
{
  "event": "job.completed",
  "job_id": "job_abc123xyz",
  "status": "completed",
  "result": {
    "video_url": "https://cdn.arteza.ai/outputs/video_abc123.mp4",
    "resolution": "1080p",
    "duration_seconds": 28.5
  },
  "credits_used": 46,
  "completed_at": "2026-04-10T14:26:45Z"
}
Esempio di handler webhook
from flask import Flask, request, jsonify

app = Flask(__name__)

@app.route("/webhooks/seedance", methods=["POST"])
def seedance_webhook():
    payload = request.get_json()

    if payload.get("event") == "job.completed":
        job_id = payload["job_id"]
        video_url = payload["result"]["video_url"]

        # La tua logica di business: scarica il video, notifica gli utenti,
        # avvia flussi di lavoro a valle, ecc.
        handle_completed_video(job_id, video_url)

    return jsonify({"received": True}), 200
Sicurezza dei webhook
Verifica le firme dei webhook se Arteza fornisce un segreto di firma. Valida sempre che i webhook provengano da Arteza prima di agire su di essi.
Vuoi provare OmniHuman v1.5? Inizia a creare gratis →

Vuoi un presentatore come questo? Prova OmniHuman gratis →
Pattern di produzione
Pattern 1: pipeline per video di vendita personalizzati
Genera un video per ogni prospect con variabili di script dinamiche.
def generate_sales_video_for_prospect(prospect):
    script = render_template("sales_template.txt", {
        "first_name": prospect["first_name"],
        "company": prospect["company"],
        "trigger": prospect["trigger_event"],
    })

    audio_url = generate_tts(script)

    job = create_omnihuman_video(
        image_url=YOUR_SDR_PHOTO_URL,
        audio_url=audio_url,
        prompt=STANDARD_SCENE_PROMPT,
        resolution="1080p",
    )
    return job["job_id"]

prospects = load_prospects_from_crm()
for prospect in prospects:
    generate_sales_video_for_prospect(prospect)
Consulta guida ai video di vendita per suggerimenti su scripting e distribuzione.
Pattern 2: lancio di contenuti multilingue
Genera lo stesso messaggio in più lingue con la stessa foto.
languages = [
    ("en", "english_audio.mp3"),
    ("es", "spanish_audio.mp3"),
    ("pt", "portuguese_audio.mp3"),
    ("fr", "french_audio.mp3"),
    ("de", "german_audio.mp3"),
]

jobs = []
for lang_code, audio_file in languages:
    audio_url = upload_to_cdn(audio_file)
    job = create_omnihuman_video(
        image_url=SPOKESPERSON_PHOTO_URL,
        audio_url=audio_url,
        prompt=STANDARD_PROMPT,
    )
    jobs.append((lang_code, job["job_id"]))
Consulta guida multilingue per suggerimenti su voce e traduzione.
Pattern 3: automazione del digest di notizie giornaliero
Pipeline pianificata che recupera i titoli, genera il TTS e produce un video giornaliero.
from datetime import datetime

def daily_news_digest():
    headlines = fetch_top_headlines()
    script = format_headlines_as_script(headlines)
    audio_url = generate_tts(script, voice="broadcast_news")

    job = create_omnihuman_video(
        image_url=NEWS_ANCHOR_PHOTO_URL,
        audio_url=audio_url,
        prompt="Professional news studio, broadcast style, medium close-up",
        resolution="720p",
    )
    return job["job_id"]

# Pianifica tramite cron, Airflow o il tuo strumento di workflow
daily_news_digest()
Consulta guida al conduttore di telegiornale.
Pattern 4: generazione video attivata dal CMS
Quando viene pubblicato un nuovo articolo del blog o un nuovo prodotto, genera un video associato.
@app.route("/cms/published", methods=["POST"])
def on_content_published():
    content = request.get_json()
    script = summarize_content(content["body"])
    audio_url = generate_tts(script)

    job = create_omnihuman_video(
        image_url=BRAND_SPOKESPERSON_PHOTO,
        audio_url=audio_url,
        prompt=BRAND_SCENE_PROMPT,
        webhook_url="https://yourapp.com/webhooks/seedance",
    )
    store_job_mapping(content["id"], job["job_id"])
    return {"ok": True}
Best practice per la gestione degli errori
Retry con backoff esponenziale
Gli errori di rete e i guasti transitori dovrebbero attivare nuovi tentativi, non un abbandono immediato.
import time

def create_with_retry(params, max_retries=3):
    delay = 2
    for attempt in range(max_retries):
        try:
            return create_omnihuman_video(**params)
        except requests.RequestException as e:
            if attempt == max_retries - 1:
                raise
            time.sleep(delay)
            delay *= 2
Valida gli input prima di inviarli
Risparmia crediti validando prima di ogni chiamata API:
- L'URL dell'immagine restituisce 200 e content-type image/*
- L'URL dell'audio restituisce 200 e content-type audio/*
- La durata dell'audio rientra nel limite per la risoluzione scelta
- Il prompt non è vuoto
Gestisci i limiti di frequenza
L'API applica limiti di frequenza. Rispetta le risposte 429 e implementa un backoff appropriato.
Monitora il saldo dei crediti
Controlla il saldo dei crediti prima di eseguire batch di grandi dimensioni. Esaurire i crediti a metà batch è evitabile.
Gestione dei costi
Un video generato tramite API costa 2,4 crediti al secondo di audio, ovvero 72 crediti ($7,20) per 30 secondi. Gli stessi crediti che alimentano l'interfaccia grafica alimentano l'API:
| Piano | Prezzo | Crediti al mese | Costo effettivo per chiamata da 30 secondi |
|---|---|---|---|
| Starter | $5 | 60 | ~$3,83 |
| Creator | $25 | 300 | ~$3,83 |
| Pro | $50 | 700 | ~$3,29 |
| Studio | $120 | 1.800 | ~$3,07 |
Per carichi di lavoro API intensi, il piano Studio offre il costo effettivo per generazione più conveniente. Consulta guida ai prezzi per i dettagli.
Stima del costo del progetto
Prima di avviare un'esecuzione in batch, calcola il costo totale:
total_cost = number_of_videos * 4.60
Un batch di 1.000 video da 30 secondi: $7.200 alla tariffa base, molto meno con un piano mensile. Pianifica il budget di conseguenza.
Prezzi API = prezzi interfaccia grafica. Nessun sovrapprezzo.
Nessuna tariffa per utente e nessun blocco su tier API. Avvia un batch quando ne hai bisogno, fermati quando non serve.
Ottieni la tua chiave APIOsservabilità
Per i flussi di lavoro in produzione, monitora queste metriche:
- Tasso di successo: percentuale di job completati con successo
- Tempo medio di generazione: per la pianificazione della capacità
- Crediti consumati: totali progressivi per il monitoraggio del budget
- Tasso di consegna dei webhook: per rilevare guasti nella consegna dei webhook
- Categorizzazione degli errori: raggruppa i fallimenti per causa
Registra i job ID insieme ai tuoi ID di correlazione interni per il debugging.
Best practice per la sicurezza
- Non esporre mai la chiave API lato client. Chiama sempre l'API dal tuo backend.
- Usa variabili d'ambiente o un gestore di segreti. Non inserire mai le chiavi nel controllo di versione.
- Ruota le chiavi periodicamente. Trattale come qualsiasi altra credenziale.
- Verifica le firme dei webhook quando disponibili.
- Usa HTTPS per tutti gli URL di immagini e audio che passi all'API.
- Limita gli endpoint webhook in modo che vengano elaborati solo i payload legittimi di Arteza.
Iniziare con l'API
- Iscriviti ad Arteza e raccogli i tuoi 10 crediti gratuiti
- Sottoscrivi almeno il piano Starter ($5/mese) per avere crediti sufficienti per una generazione di test
- Genera la tua chiave API nel dashboard
- Prepara un'immagine e un file audio di test, caricali su un URL pubblico
- Effettua la tua prima chiamata API usando gli esempi sopra
- Esegui il polling o attendi il webhook per recuperare l'URL del video
- Costruisci la tua pipeline di produzione
Per ulteriori letture correlate, consulta guida completa a OmniHuman v1.5, dettaglio dei prezzi, guida ai video di vendita e guida multilingue.
Vuoi provare OmniHuman v1.5? Inizia a creare gratis →
Prova OmniHuman v1.5 - Ora stesso
Carica la tua immagine di riferimento nella pagina di creazione.
5 generazioni gratuite · Nessuna carta di credito richiesta