AI-videogenerering med flera indata: komplett guide
AI-video med flera indata innebär att du matar modellen med mer än bara text. Här är den kompletta guiden till att använda bilder, video och ljud som indata i Seedance 2.0 Reference.
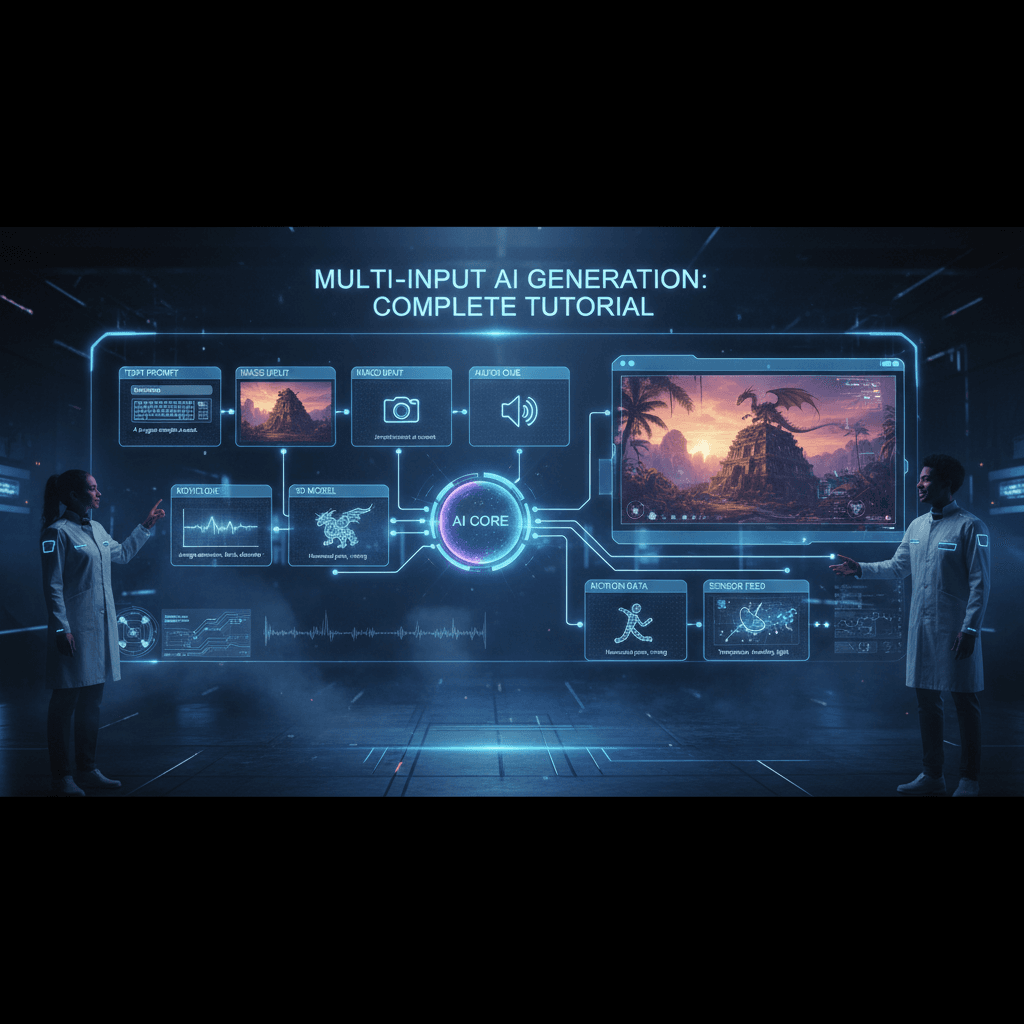
Nästa fas av AI-video handlar inte om bättre promptar, det handlar om bättre indata. I två år har branschen optimerat en enda spak: textprompten. Den spaken har nått sitt tak. Det verkliga genombrottet ligger i att acceptera rikare indata: bilder, videoklipp, ljud och kombinationer av alla tre.
Seedance 2.0 Reference är den mest fullt ut multi-indata-baserade AI-videomodellen som finns tillgänglig idag, och det här är den kompletta guiden för att använda varje indatatyp tillsammans.
Sammanfattning
- Multi-indata = text + upp till 9 bilder + upp till 3 videoklipp + upp till 3 ljudklipp
- Varje indatatyp styr olika dimensioner i resultatet (stil, rörelse, stämning)
- Allt sammanfogas i en enda generering för $0.3024/sek
- Genereringstid: 60-180 sekunder oavsett antal indata
- Det mest effektiva arbetsflödet för precis AI-video
- Prova hela multi-input-stacken gratis
Varför multi-indata spelar roll
Text är komprimerad visuell information. När du skriver "mörk, varm, filmisk" tar du ett rikt visuellt koncept och komprimerar det med förlust till sju stavelser. Modellen måste sedan expandera dessa sju stavelser tillbaka till visuella element, och den expansionen tappar information.
Multi-indata hoppar över komprimeringsteget. Istället för att beskriva din stil med ord visar du den direkt. Istället för att beskriva rörelse visar du den. Istället för att beskriva stämning visar du den. Modellen läser dina indata med full kvalitet.
Resultatet är ett utdata som träffar intentionen mer precist, vid första genereringen, utan lika mycket promptiterering.
5 gratis generationer · Inget kreditkort krävs
De fyra indatatyperna
1. Textprompt (obligatorisk). Det enda text bör göra i ett multi-indata-arbetsflöde: beskriva subjektet och handlingen. Lämna stil, stämning och rörelse till de övriga indatatyperna.
2. Referensbilder (upp till 9). Primärt stilindata. Täck färg, belysning, komposition, korn och textur.
3. Referensvideor (upp till 3). Rörelseindata. Fånga kamerarörelser, tempo och handlingsrytm.
4. Referensljud (upp till 3). Stämningsindata. Påverkar det visuella resultatet känslomässigt, inte via utdatats faktiska ljudspår.
Tillsammans ger dessa dig kontroll över varje dimension i resultatet utan att förlita dig på text för att göra allt.
Hur sammanfogningen fungerar
Under huven bearbetar Seedance 2.0 Reference varje indatatyp via dedikerade enkodrar och sammanfogar resultaten till en enda konditioneringssignal. Textprompten går genom en textenkoder, bilder går genom en bildenkoder, video går genom en rörelseenkoder och ljud går genom en ljudstämningsenkoder.
Den sammanfogade konditioneringssignalen används sedan för att styra videogenereringsprocessen. Du ser inget av detta, du ser bara att indata går in och video kommer ut. Men att förstå sammanfogningen hjälper dig att tänka på vilka indata du bör ge mer tyngd.
Ungefärlig viktordning:
- Text: stark påverkan på subjekt och handling
- Bilder: stark påverkan på visuell stil
- Video: stark påverkan på rörelse
- Ljud: subtil påverkan på visuell stämning
En saknad indatatyp bryter inte genereringen. Den lämnar bara den dimensionen till standardbeteende, vilket ofta fungerar bra för enklare arbeten.

Kör din första multi-indata-generering. Ladda upp alla tre indatatyper och se precisionen. Kom igång gratis.
Ett komplett multi-indata-exempel
Här är en generering där varje indatatyp används.
Textprompt:
En kvinna i en läderjacka sitter på en motorcykel i en neonskimrande
gränd på natten, kameran rör sig långsamt framåt, 8 sekunder
Bildreferenser (7):
- 3 stillbilder från Blade Runner (färg, belysning)
- 2 cyberpunk-fotografier (komposition, korn)
- 1 produktbild på motorcykel (subjektplacering)
- 1 hjältebild (övergripande målstämning)
Videoreferens (1):
- 3-sekunders klipp av en långsam dolly-rörelse mot ett subjekt
Ljudreferens (1):
- 5-sekunders klipp av ett syntdrone med subtilt regn
Resultat:
- Stil: Tydlig Blade Runner-känsla, låst av bilderna
- Rörelse: Matchar dolly-referensen precist
- Stämning: Subtil regnmättad atmosfär från ljudindata
Totalt antal indata: 7 bilder + 1 video + 1 ljud + 1 prompt. Genereringstid: ~120 sekunder. Resultat: exakt det jag ville ha vid första försöket.
Jämför det med promptbaserade arbetsflöden där det ofta krävs 5-10 genereringar för att komma nära det tänkta utseendet. Multi-indata sparar iterationskostnader och matchar intentionen mer precist.
När du bör lägga till varje indatatyp
Du behöver inte alltid alla fyra. Här är när varje typ tillför värde.
Enbart text: Aldrig. Du behöver alltid minst en referenstyp för Reference-läget.
Text + bilder: Den vanligaste uppsättningen. Fungerar för 70% av projekten.
Text + bilder + video: När du behöver specifik rörelse som är svår att beskriva.
Text + bilder + ljud: När stämningen behöver gå bortom vad bilder ensamma kan förmedla.
Alla fyra: När maximal precision är viktig, varumärkesarbete, hjältebilder och slutleveranser.
Börja med text + bilder och lägg till övriga indata när du stöter på gränserna för den uppsättningen.
Multi-indata-arbetsflöden för olika användningsområden
För varumärkesvideor: Text + 6-9 varumärkesbilder + 1-2 rörelsereferenser som visar din signatur-kamerastil. Hoppa över ljudreferenser om du inte har ett specifikt stämningsmål.
För musikvideor: Text + 6-9 stilbilder + 1 ljudreferens som matchar låtens stämning. Videoreferenser är valfria.
För storyboards: Text + 4-6 konceptbilder + 1 rörelsereferens per bildtyp. Hoppa över ljud.
För produktlanseringar: Text + 5-7 produktfoton + 1 livsstils- eller varumärkesrörelsereferens. Hoppa över ljud om inte produkten har specifika stämningsassociationer.
För redaktionellt och mode: Text + 6-9 lookbook-foton + 1 gång- eller posrörelsreferens. Hoppa över ljud om inte fotograferingen har ett tillhörande soundtrack.
Prova Seedance 2.0 Reference, multimodal videogenerering
Full multi-indata-kontroll: bilder, video och ljudreferenser i ett anrop. Gratis krediter, inget kort krävs.
Prova Seedance 2.0 Reference gratisKostnad och hastighetshänsyn
Multi-indata-genereringar kostar samma per sekund som enkla indata-genereringar: $0.3024 per sekund av utdata. Att lägga till referenstyper ökar inte kostnaden.
| Längd | Krediter | Kostnad |
|---|---|---|
| 4 sek | 19 | $1.90 |
| 8 sek | 37 | $3.70 |
| 15 sek | 69 | $6.90 |
Hastighet: Multi-indata-genereringar tar något längre tid än enbart textbaserade, eftersom modellen bearbetar mer indata. Räkna med 90-180 sekunder för multi-indata-anrop jämfört med 60-120 sekunder för bilddrivna anrop. Den extra väntetiden är nästan alltid värd precisionsvinsten.
Vanliga misstag med multi-indata
Motstridiga indata. Om dina bilder säger "mörk och långsam" och ditt ljud säger "pigg och snabb" blir sammanfogningen förvirrad. Välj indata som är överens om stämningen.
Att använda videoreferenser för stil. Videoreferenser påverkar endast rörelse, inte stil. Välj dem inte utifrån hur de ser ut visuellt.
Att överlasta ljud. En eller två ljudreferenser är vanligtvis tillräckligt. Tre kan späda ut stämningssignalen.
Att hoppa över prompten. Även med starka referenser behöver du en textprompt för subjekt och handling. En tom prompt ger generiskt innehåll.
Att ändra indata mellan klipp i en serie. Om du producerar flera klipp som ska kännas sammanhängande, använd identiska referenspaket för dem alla.
Att jämföra multi-indata med enkla indata
Här är en jämförelse sida vid sida som jag körde med samma scenario.
Scenario: Kort atmosfäriskt klipp av en regnblöt stadsgata på natten.
Försök med enbart text:
Atmosfärisk bild av en regnblöt stadsgata på natten, neonreflektioner,
mörk filmisk belysning, långsam kamerarörelse framåt, 5 sekunder
Resultat: Hyfsat men generiskt. Kunde vara vilket som helst noir-stilat AI-klipp. Fick det att fungera vid 4:e genereringen efter promptiterering.
Försök med multi-indata:
- Samma prompt utan stilbeskrivningar
- 6 Blade Runner-stillbilder
- 1 dolly-videoreferens
- 1 regnig syntljudreferens
Resultat: Specifikt, låst och matchade min tänkta känsla vid första försöket.
Tidsbesparing: ~8 minuters iterering eliminerades. Kostnadsbesparing: 3 färre genereringsförsök à ~$3 styck = ~$9 sparat.
Multiplicerat över ett projekt med 20+ klipp betalar sig multi-indata-arbetsflöden många gånger om.
Multi-indata jämfört med standard Seedance 2.0
Värt att notera: standard Seedance 2.0 är ett arbetsdrag för text-till-video och bild-till-video. Det är enkelt indata. Om du bara behöver en prompt och en bild är standard snabbare att sätta upp.
Multi-indata med Seedance 2.0 Reference är för när precision är viktigare än uppstartshastighet. Se det fullständiga Jämförelse mellan Reference och Standard för beslutsramverket.
Tips för förberedelse av indata
Bilder: Minst 512 px på kortsidan, JPG eller PNG, helst från en konsekvent stilkälla.
Video: 2-5 sekunder per klipp, valfritt bildförhållande, MP4 föredras.
Ljud: 4-10 sekunder per klipp, MP3 eller WAV, matcha din målstämning.
Övertänk inte förberedelsen av indata. Modellen är ganska förlåtande när det gäller upplösning, format och filstorlek. Det som spelar roll är innehållets relevans, inte teknisk perfektion.
Att bygga ett multi-indata-bibliotek
Erfarna användare bygger ett personligt bibliotek av återanvändbara indata:
- Stilpaket för olika genrer och stämningar (noir, pastoral, episk osv.)
- Rörelsevideoklipp för vanliga kamerarörelser (dolly in, handhållen, statisk osv.)
- Ljudcues för känslomässiga toner (melankolisk, hoppfull, spänd osv.)
Med ett bibliotek handlar det bara om att kombinera befintliga indata när ett nytt projekt startar, istället för att hitta allt från grunden. Du utvecklar ett "sound", en igenkännbar stil som bär igenom ditt arbete eftersom dina indata är konsekventa.
Gå vidare
För en praktisk fördjupning i multimodal kombination, läs multimodal AI-video. För det bildspecifika arbetsflödet, se handledning för flera bilder. För en övergripande genomgång av funktionerna är Komplett guide till Seedance 2.0 Reference rätt läsning.
Multi-indata är hur AI-video blir precis. Lär dig arbetsflödet en gång och din genereringskvalitet förbättras permanent.
Prova hela multi-indata-stacken
Ladda upp bilder, video och ljudreferenser i en enda generering. Gratis krediter, inget kort krävs.
Börja skapa gratisProva Seedance 2.0 - Just nu
5 gratis generationer · Inget kreditkort krävs