AI lip sync med OmniHuman v1.5: lydstyrerede avatarer
Et teknisk dyk ned i OmniHuman v1.5's læbesynkroniseringsteknologi. Lær hvordan fonemudtrækning, visemekortlægning og tidsmæssig justering arbejder sammen om at skabe billedpræcis lip sync til AI-avatarvideoer.
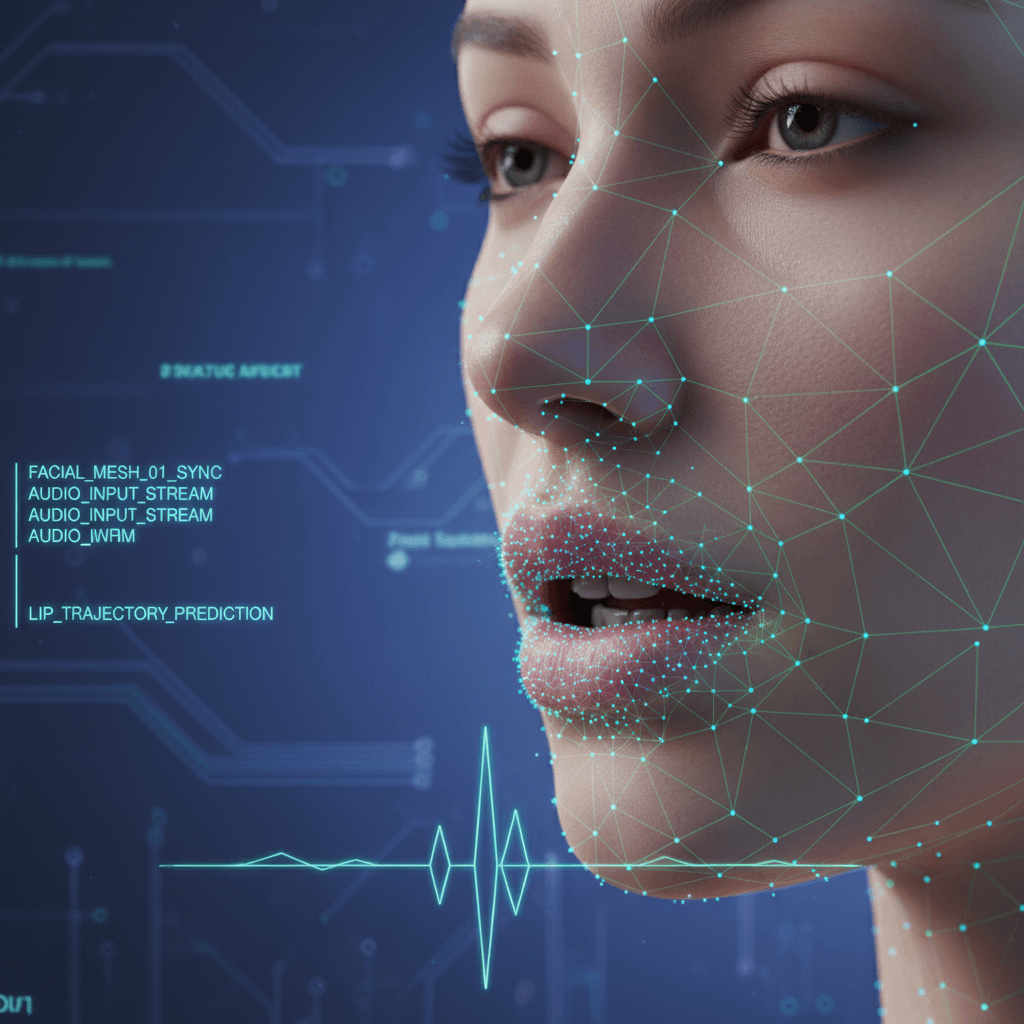
De fleste AI-avatarer fejler læbesynkroniseringstesten inden for tre sekunder: munde åbner og lukker nogenlunde i takt med lyden, men de specifikke former matcher ikke de lyde, der faktisk tales. OmniHuman v1.5 lukker det hul ved at kortlægge fonemer, de atomare enheder i tale, til præcise mundkonfigurationer på hvert eneste billede. Sådan får du læbesynkronisering, der holder, når seerne ser nøje med lyden tændt.
TL;DR
- OmniHuman v1.5 bruger læbesynkronisering på fonem-niveau, ikke blot timingbaseret mundanimation
- Modellen udtrækker taleyde fra din lyd og kortlægger dem til visemer (mundformer)
- Ren lyd-input forbedrer synkroniseringsnøjagtigheden markant
- En 30-sekunders læbesynkroniseret video koster $7,20 (72 credits) på abonnementer fra $5 om måneden
- Virker på alle talte sprog med stærk træningsrepræsentation
Hvorfor de fleste AI-læbesynkroniseringer kommer til kort
Ældre avatar-værktøjer benytter typisk en af to genveje:
Timingbaseret animation. Munden åbner og lukker baseret på lydstyrketoppene. Høje øjeblikke = åben mund, stille øjeblikke = lukket mund. Det ser acceptabelt ud på afstand, men fejler øjeblikkeligt ved nærmere eftersyn, fordi de specifikke former er forkerte.
Fast viseme-cyklus. Et lille bibliotek af generiske mundformer looper som reaktion på brede talekategorier. Det er bedre end ren lydstyrkedrevet animation, men overser stadig de subtile forskelle mellem lignende lyde.
Resultatet i begge tilfælde er "den uhyggelige dal for mundbevægelse", noget der fremstår som næsten virkeligt, men tydeligt syntetisk for enhver, der er opmærksom.
Opret din AI-præsentør nu
Gør ét foto og lyd til en naturtro talende video. $7,20 pr. 30-sekunders video på abonnementer fra $5 om måneden.
Prøv OmniHuman gratis5 gratis generationer · Intet kreditkort påkrævet
Hvad OmniHuman v1.5 gør anderledes
OmniHuman v1.5 behandler læbesynkronisering som et struktureret tale-til-form-kortlægningsproblem. Processen kører i fire trin.
Trin 1: Fonemudtrækning
Din lyd passerer gennem en akustisk model, der identificerer individuelle fonemer, de mindste enheder af distinkte lyde i talt sprog. Engelsk har omkring 44 fonemer. Spansk har cirka 24. Mandarin har et helt andet sæt. Modellen genkender fonemer med tidsnøjagtighed til millisekundet.
Trin 2: Viseme-kortlægning
Hvert fonem kortlægges til et eller flere visemer, visuelt distinkte mundformer. Et visem for "/p/" viser lukning af læber før frigivelse. Et visem for "/f/" viser overkæbetænder mod underlæben. Et visem for "/o/" viser en rundet åben mund. Kortlægningen fra fonem til visem er sprogbevidst og tager kontekst i betragtning.
Trin 3: Temporal justering
Visemer justeres til specifikke videobilleder baseret på fonem-timing. Ved 30 billeder pr. sekund får hvert billede den mundform, der svarer til det præcise udsnit af lyd, det repræsenterer. Overgange mellem visemer udjævnes for at undgå rystende mundbevægelse.
Trin 4: Diffusionsrendering
Det endelige renderingstrin genererer de faktiske pixels og inkorporerer viseme-information sammen med identitetsfunktioner fra referencefotoet, prosodidrevet ansigtsudtryk og sceneprompt. Munden er ikke "klæbet på", den genereres som en del af hvert enkelt billede.
Hvorfor dette betyder noget for seerne
Her er, hvad læbesynkronisering på fonem-niveau ser ud som i praksis, når du er opmærksom på specifikke lyde.
Plosiver (p, b, t, d, k, g): Lukning af læber eller tunge før lyden, derefter frigivelse. OmniHuman viser lukningen tydeligt.
Frikativer (f, v, s, z, sh, th): Luft, der strømmer gennem et indsnævret punkt. "F" og "V" kræver overkæbetænder mod underlæben, hvilket OmniHuman gengiver præcist.
Vokaler (a, e, i, o, u): Forskellige grader af kæbeåbning og læberunding. "Oh" og "Ah" ser distinkte ud, som de bør.
Diftonger (oi, ou, ay): Glidende overgange mellem to vokalformer. Modellen renderer bevægelsen jævnt på tværs af billeder.
Nasaler (m, n, ng): Lukket eller næsten lukket mund med luftstrøm gennem næsen. Den subtile forskel mellem "m" (læber lukket) og "n" (tunge mod den alveolære ryg) vises gennem let kæbepositionering.
Når alt dette håndteres korrekt, holder du op med at lægge mærke til læbesynkroniseringen overhovedet. Det er målet, usynlighed.
Sådan får du den bedste læbesynkronisering
Kvaliteten af dit lyd-input er den absolut vigtigste faktor for nøjagtighed i læbesynkronisering. Sådan optimerer du.
Brug ren, isoleret tale
Musik, baggrundssnak, kraftig baggrundsstøj og rumklang forstyrrer alle fonemudtrækning. Inden du uploader lyd:
- Fjern eller sænk musik eller lydeffekter
- Optag i et stille rum, eller brug en støjport
- Undgå rum med kraftig ekko
- Undlad at integrere effekter som kraftig kompression eller EQ
Sigt efter professionel optagekvalitet
Du behøver ikke et radiosstudie, men en USB-kondensatormikrofon i et stille rum slår en laptop-mikrofon hver gang. Målspecifikationer:
- 44,1 kHz eller 48 kHz samplingsfrekvens
- 16-bit eller 24-bit dybde
- Mono eller stereo er begge acceptabelt
- Toppunktsniveauer omkring -3 dB, ingen klipning
Tal i et naturligt tempo
Forhastet eller monoton tale giver mindre overbevisende læbesynkronisering end naturlig, varieret fremsigelse. Tal, som du ville gøre det i en rigtig samtale, med naturlige pauser og betoning.
Trim indledende og afsluttende stilhed
OmniHuman genererer video for den fulde lydvarighed. Hvis din lyd starter med 3 sekunders stilhed, spilder du billeder. Trim tæt.
Hold dig inden for varighed-grænser
OmniHuman v1.5 understøtter op til 60 sekunder ved 720p og 30 sekunder ved 1080p. Klip tæt på grænsen oplever sommetider kvalitetsfald på de sidste billeder. Sigt efter et sekund eller to under grænsen.
Klar til at prøve OmniHuman v1.5? Begynd at skabe gratis →

Vil du have en præsentør som denne? Prøv OmniHuman gratis →
Sprogspecifikke overvejelser
Fonembeholdninger varierer på tværs af sprog, og modellens nøjagtighed varierer med træningsdatarepræsentationen.
Bredt trænede sprog
Engelsk, mandarin, spansk, portugisisk, fransk, tysk, japansk og koreansk modtager alle høj-nøjagtig læbesynkronisering. Disse sprog har robuste træningsdata, og fonemer kortlægges til visemer med billedpræcision.
Godt understøttede sprog
Italienisk, russisk, arabisk, hindi, indonesisk, vietnamesisk og tyrkisk fungerer pålideligt med stærk læbesynkroniseringskvalitet. Mindre variationer i regionale accenter kan påvirke specifikke fonemer en smule.
Fremvoksende sprogunderstøttelse
Mindre almindelige sprog virker, men nøjagtigheden på sjældne fonemer kan være lavere. Test med en kort prøve, inden du begiver dig ud i en stor produktion.
For flersprogede projekter, se flersproglig guide for stemme-anbefalinger og lokaliseringsworkflows.
Almindelige læbesynkroniseringsproblemer og løsninger
Mundbevægelser føles en smule forsinkede
Årsag: Lydfilen har stille polstring i starten, eller kompressionsartefakter har forskudt fonem-timingen. Løsning: Trim indledende stilhed, eksporter igen ved højere bithastighed (MP3 192 kbps eller højere, eller WAV).
Mundformer ser for generiske ud
Årsag: Lyden er støjende eller sløret, hvilket skader fonemudtrækning. Løsning: Optag igen et et roligere sted, eller kør lyden igennem et støjreduktionsværktøj.
Synkronisering virker for vokaler, men konsonanter ser bløde ud
Årsag: Lav-kvalitets mikrofon eller kraftig kompression, der blødgør konsonant-transienter. Løsning: Brug en bedre mikrofon, reducer kompression, eller brug TTS, der producerer renere konsonanter.
Læbesynkronisering bryder sammen ved visse accenter
Årsag: Regionale accent-fonemvarianter kan være underrepræsenterede i træningsdata. Løsning: Prøv en neutral accent-stemme til det samme sprog, eller brug professionelt TTS med valgbare regionale stemmer.
Synkronisering driver ved længere klip
Årsag: Lydur og videoklokke kommer ud af justering ved den yderste ende af varighed. Løsning: Hold dig et sekund eller to under varighed-grænsen. Opdel længere indhold i segmenter.
Test af læbesynkroniseringskvalitet
Inden du begiver dig ud i en lang produktionskørsel, test med en kort prøve.
10-sekunders testen
- Optag et 10-sekunders lydklip med denne præcise sætning: "Peter picked pepper, five fish fried, shy shepherds sigh."
- Upload med dit valgte referencefoto til OmniHuman v1.5
- Generer og afspil i 100 % størrelse
- Hold øje med:
- Tydelig læbelukning på "P"-lyde
- Overkæbetænder mod underlæben for "F"
- Forskellige mundformer for "sh" og "s"
- Rene overgange mellem fonemer
Hvis 10-sekunders testen ser ren ud, vil 30-60-sekunders produktionen også se ren ud.
Side-om-side-sammenligning
Afspil OmniHuman-output ved siden af din referencelyd i høretelefoner. Luk øjnene, og åbn dem derefter. Hvis mundbevægelserne føles "åbenlyse", når du genopretter fokus på videoen, virker synkroniseringen. Hvis de føles "forkerte", kræver noget i lydprocessen opmærksomhed.
Hvordan læbesynkronisering passer ind i den fulde genereringspipeline
Læbesynkronisering er ét af flere parallelle systemer, der kører under OmniHuman-generering. Den fulde pipeline inkluderer:
- Identitetsbevarelse fra referencefotoet
- Ansigtsudtryk drevet af lydens emotion og prosodi
- Hoofdbevægelse, der korrelerer med taleritmen
- Skulder- og overkropsbevægelser synkroniseret til betoning
- Baggrund og scenerendering fra din prompt
- Temporal sammenhæng på tværs af billeder
Læbesynkronisering eksisterer ikke isoleret, det er ét lag i et større generativt system. Når alt fungerer sammen, ser seerne en naturlig optagelse frem for et talende hoved med god mundbevægelse.
For den fulde tekniske oversigt, se komplet guide til OmniHuman v1.5.
Fonem-præcis synkronisering, $7,20 for 30 sekunder
Ingen synkroniseringskvalitetsniveauer og ingen prissætning pr. bruger. Én pris pr. video, og dine månedlige credits fornyes ved hver faktureringscyklus.
Test synkroniseringenPris og adgang
Enhver OmniHuman v1.5-generering, inklusive læbesynkronisering, koster 3-72 credits ($0,30-$7,20), som afspejler længden af din lyd: 2,4 credits pr. sekund. Intet tillæg for læbesynkronisering, ingen lagdelt synkroniseringskvalitet. Du får den samme nøjagtighed på fonem-niveau ved hver render.
Nye Arteza-konti modtager 10 gratis credits ved tilmelding. Starter-abonnementet til $5 giver dig 60 credits om måneden, nok til én tredive-sekunders generering plus udforskning. Se prisguide for alle detaljer.
Begynd at teste læbesynkroniseringskvalitet
- Opret en konto på Arteza og indløs 10 gratis credits
- Abonner på Starter-planen til $5
- Forbered et kort tungevrider-lydklip og et portræt-foto
- Åbn OmniHuman v1.5
- Generer og evaluer
For dybere kontekst, se komplet guide til OmniHuman v1.5, talking head-tutorial og flersproglig guide.
Klar til at prøve OmniHuman v1.5? Begynd at skabe gratis →
Prøv OmniHuman v1.5 - Lige nu
Upload dit referencebillede på opret-siden.
5 gratis generationer · Intet kreditkort påkrævet