AI-läppsynkronisering med OmniHuman v1.5: ljuddrivna avatarer
En teknisk djupdykning i OmniHuman v1.5:s läppsynkroniseringsteknik. Lär dig hur fonemextraktion, visemmappning och temporal justering samverkar för att skapa bildruteexakt läppsynkronisering för AI-avatarvideor.
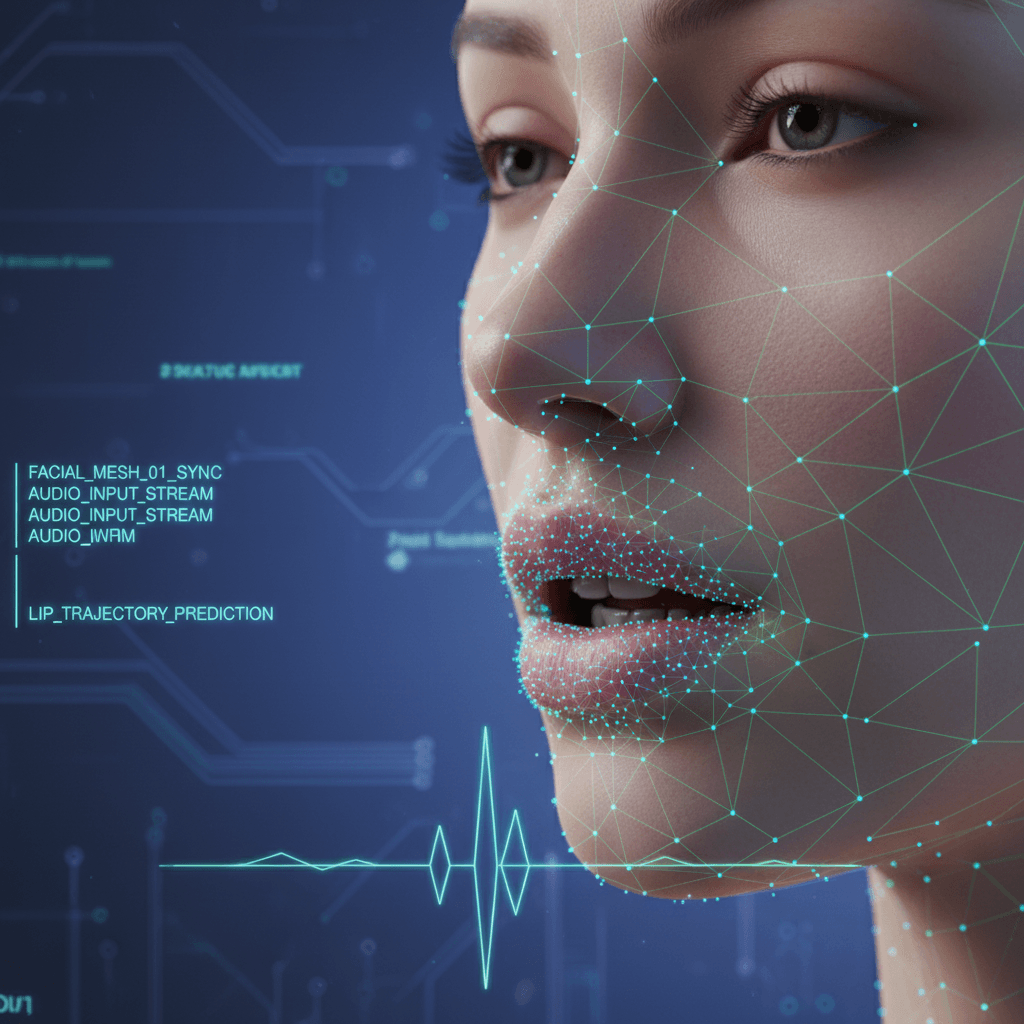
De flesta AI-avatarer misslyckas med läppsynkroniseringstestet inom tre sekunder: munnar öppnas och stängs ungefär i takt med ljudet, men de specifika formerna matchar inte de faktiska ljud som uttalas. OmniHuman v1.5 stänger det gapet genom att mappa fonem, talets atomära enheter, till exakta munkonfigurationer i varje enskild bildruta. Det är så du får en läppsynkronisering som håller när tittarna tittar noga med ljudet på.
TL;DR
- OmniHuman v1.5 använder fonembaserad läppsynkronisering, inte bara tidsstyrd munanimering
- Modellen extraherar talljud från ditt ljud och mappar dem till visemer (munformer)
- Rent ljudindata förbättrar synkroniseringsprecisionen avsevärt
- En 30 sekunder lång läppsynkroniserad video kostar $7,20 (72 credits) på planer från $5 i månaden
- Fungerar på alla talade språk med stark representation i träningsdatan
Varför de flesta AI-läppsynkroniseringar brister
Traditionella avatarverktyg tar vanligtvis en av två genvägar:
Tidsstyrd animering. Munnen öppnas och stängs baserat på ljudvolymens toppar. Höga stunder = öppen mun, tysta stunder = stängd mun. Det ser acceptabelt ut på avstånd men misslyckas omedelbart vid närstudie eftersom de specifika formerna är fel.
Fast visemcykling. Ett litet bibliotek med generiska munformer loopar som svar på breda talskategorier. Det är bättre än rent volymstyrd animering men missar fortfarande de subtila skillnaderna mellan liknande ljud.
Resultatet i båda fallen är "den obehagliga dalen för munrörelser", något som upplevs som nästan äkta men tydligt syntetiskt för den som uppmärksammar det.
Skapa din AI-presentatör nu
Förvandla ett foto och ljud till en naturtrogen talvideo. $7,20 per 30-sekunders video på planer från $5 i månaden.
Prova OmniHuman gratis5 gratis generationer · Inget kreditkort krävs
Vad OmniHuman v1.5 gör annorlunda
OmniHuman v1.5 behandlar läppsynkronisering som ett strukturerat tal-till-form-mappningsproblem. Processen körs i fyra steg.
Steg 1: Fonemextraktion
Ditt ljud passerar genom en akustisk modell som identifierar enskilda fonem, de minsta enheterna av distinkt ljud i talat språk. Engelska har ungefär 44 fonem. Spanska har cirka 24. Mandarin har en annan uppsättning. Modellen känner igen fonem med en tidsprecision på millisekunden.
Steg 2: Visemmappning
Varje fonem mappas till ett eller flera visemer, visuellt distinkta munformer. Ett visem för "/p/" visar läppslutning innan explosionen. Ett visem för "/f/" visar övertänderna mot underläppen. Ett visem för "/o/" visar en rundad öppen mun. Fonem-till-visem-mappningen är språkmedveten och tar hänsyn till kontexten.
Steg 3: Temporal justering
Visemer justeras till specifika bildrutor baserat på fonemtiming. Vid 30 bildrutor per sekund får varje bildruta den munform som matchar den exakta ljudslicen den representerar. Övergångarna mellan visemer jämnas ut för att undvika ryckiga munrörelser.
Steg 4: Diffusionsrendering
Det sista renderingssteget genererar de faktiska pixlarna och inkorporerar viseminformation tillsammans med identitetsdrag från referensfotot, prosodistyrt ansiktsuttryck och scenpromten. Munnen är inte "inklistrad", den genereras som en del av varje bildruta.
Varför det spelar roll för tittarna
Så här ser fonembaserad läppsynkronisering ut i praktiken när du uppmärksammar specifika ljud.
Klusiler (p, b, t, d, k, g): Läpp- eller tungslutning innan ljudet, sedan explosion. OmniHuman visar slutningen tydligt.
Frikativor (f, v, s, z, sj, th): Luft som flödar genom en förträngd punkt. "F" och "V" kräver övertänderna mot underläppen, vilket OmniHuman återger exakt.
Vokaler (a, e, i, o, u): Olika grader av käköppning och läpprundning. "O" och "A" ser distinkt olika ut, som de ska.
Diftonger (oj, au, aj): Glidande övergångar mellan två vokalformer. Modellen renderar rörelsen mjukt över bildrutorna.
Nasaler (m, n, ng): Stängd eller nästan stängd mun med luftflöde genom näsan. Den subtila skillnaden mellan "m" (läpparna stängda) och "n" (tungan mot alveolarkammen) framträder genom liten käkpositionering.
När allt detta hanteras korrekt slutar du märka läppsynkroniseringen överhuvudtaget. Det är målet, osynlighet.
Så får du bästa möjliga läppsynkronisering
Kvaliteten på ditt ljudindata är den enskilt viktigaste faktorn för läppsynkroniseringens precision. Här är hur du optimerar.
Använd rent, isolerat tal
Musik, bakgrundssorl, kraftigt omgivningsljud och rumseko stör fonemextraktionen. Innan du laddar upp ljud:
- Ta bort eller dämpa all musik eller ljudeffekter
- Spela in i ett tyst rum eller använd en noise gate
- Undvik rum med starkt eko
- Baka inte in effekter som kraftig kompression eller EQ
Sikta på professionell inspelningskvalitet
Du behöver inget broadcast-studio, men en USB-kondensatormikrofon i ett tyst rum slår en laptopsmikrofon varje gång. Målspecifikationer:
- 44,1 kHz eller 48 kHz samplingsfrekvens
- 16-bitars eller 24-bitars djup
- Mono eller stereo fungerar båda
- Toppnivåer runt -3 dB, ingen klippning
Tala i naturlig takt
Hetsigt eller monotont tal ger mindre övertygande läppsynkronisering än ett naturligt, varierat framförande. Tala som du skulle göra i ett riktigt samtal, med naturliga pauser och betoning.
Klipp bort inledande och avslutande tystnad
OmniHuman genererar video för hela ljudets längd. Om ditt ljud börjar med 3 sekunders tystnad slösar du bildrutor. Klipp tätt.
Håll dig inom längdgränserna
OmniHuman v1.5 stöder upp till 60 sekunder vid 720p och 30 sekunder vid 1080p. Klipp nära gränsen kan ibland uppleva kvalitetsfall i de sista bildrutorna. Sikta på en eller två sekunder under gränsen.
Redo att prova OmniHuman v1.5? Börja skapa gratis →

Vill du ha en presentatör som den här? Prova OmniHuman gratis →
Språkspecifika överväganden
Fonemuppsättningar skiljer sig åt mellan språk, och modellens precision varierar med representationen i träningsdatan.
Vältränade språk
Engelska, mandarin, spanska, portugisiska, franska, tyska, japanska och koreanska får alla hög precision i läppsynkroniseringen. Dessa språk har robusta träningsdata och fonem mappas till visemer med bildruteprecision.
Väl stödda språk
Italieniska, ryska, arabiska, hindi, indonesiska, vietnamesiska och turkiska fungerar tillförlitligt med god läppsynkroniseringskvalitet. Mindre variationer i regionala accenter kan påverka specifika fonem något.
Framväxande språkstöd
Mindre vanliga språk fungerar, men precisionen på sällsynta fonem kan vara lägre. Testa med ett kort prov innan du åtar dig en stor produktion.
För flerspråkiga projekt, se flerspråkig guide för röstrekommendationer och lokaliseringsarbetsflöden.
Vanliga läppsynkroniseringsproblem och lösningar
Munrörelserna känns något försenade
Orsak: Ljudfilen har tysta utfyllnadsdelar i början, eller komprimeringsartefakter har förskjutit fonemtimingen. Lösning: Klipp bort inledande tystnad, exportera om med högre bithastighet (MP3 192 kbps eller högre, eller WAV).
Munformerna ser för generiska ut
Orsak: Ljudet är brusigt eller grumligt, vilket skadar fonemextraktionen. Lösning: Spela in igen i ett tystare utrymme, eller kör ljudet genom ett brusreduceringsverktyg.
Synkroniseringen fungerar för vokaler men konsonanterna ser suddiga ut
Orsak: Lågkvalitativ mikrofon eller kraftig kompression som mjukar upp konsonanternas transienter. Lösning: Använd en bättre mikrofon, minska komprimeringen, eller använd TTS som ger renare konsonanter.
Läppsynkroniseringen brister på vissa accenter
Orsak: Regionala accentfonemvarianter kan vara underrepresenterade i träningsdatan. Lösning: Prova en neutral accentröst för samma språk, eller använd professionellt TTS med valbara regionala röster.
Synkroniseringen glider på längre klipp
Orsak: Ljudklockan och videoklockan hamnar ur fas i den yttersta änden av längden. Lösning: Håll dig en eller två sekunder under längdgränsen. Dela längre innehåll i segment.
Testa läppsynkroniseringskvaliteten
Innan du åtar dig en lång produktionsprocess, testa med ett kort prov.
10-sekunderstestet
- Spela in ett 10 sekunder långt ljudklipp med den här exakta meningen: "Peter picked pepper, five fish fried, shy shepherds sigh."
- Ladda upp med ditt valda referensfoto till OmniHuman v1.5
- Generera och spela upp i 100 % storlek
- Titta efter:
- Tydlig läppslutning på "P"-ljud
- Övertänderna mot underläppen för "F"
- Olika munformer för "sh" och "s"
- Rena övergångar mellan fonem
Om 10-sekunderstestet ser rent ut kommer den 30-60 sekunder långa produktionen också att se rent ut.
Jämförelse sida vid sida
Spela upp OmniHuman-resultatet bredvid ditt referensljud i hörlurar. Blunda, öppna sedan ögonen. Om munrörelserna känns "uppenbara" när du återfokuserar på videon fungerar synkroniseringen. Om de känns "fel" behöver något i ljudpipelinen ses över.
Hur läppsynkronisering passar in i hela genereringspipelinen
Läppsynkronisering är ett av flera parallella system som körs under OmniHuman-generering. Den fullständiga pipelinen inkluderar:
- Identitetsbevakning från referensfotot
- Ansiktsuttryck drivet av ljudets känslor och prosodi
- Huvudrörelse som korrelerar med talrytm
- Axel- och överkroppsrörelser synkroniserade med betoning
- Bakgrunds- och scenrendering från din prompt
- Temporal koherens över bildrutorna
Läppsynkronisering existerar inte isolerat, det är ett lager i ett större generativt system. När allt fungerar tillsammans ser tittarna en naturlig inspelning snarare än ett talande huvud med bra munrörelse.
För den fullständiga tekniska översikten, se fullständig guide till OmniHuman v1.5.
Fonemexakt synkronisering, $7,20 för 30 sekunder
Inga synkroniseringskvalitetsnivåer och ingen per-plats-prissättning. Ett pris per video, och dina månadsliga credits förnyas varje faktureringscykel.
Testa synkroniseringenKostnad och åtkomst
Varje OmniHuman v1.5-generering, inklusive läppsynkronisering, kostar 3-72 credits ($0,30-$7,20), vilket följer längden på ditt ljud: 2,4 credits per sekund. Inget läppsynkroniseringstillägg, ingen nivåindelad synkkvalitet. Du får samma fonembaserade precision vid varje rendering.
Nya Arteza-konton får 10 gratis credits vid registrering. $5-starterplanen ger dig 60 credits i månaden, tillräckligt för en trettio sekunder lång generering plus utforskning. Se prisguide för fullständiga detaljer.
Börja testa läppsynkroniseringskvaliteten
- Registrera dig på Arteza och hämta 10 gratis credits
- Prenumerera på $5-starterplanen
- Förbered ett kort tungvrickar-ljud och ett porträttfoto
- Öppna OmniHuman v1.5
- Generera och utvärdera
För djupare sammanhang, se fullständig guide till OmniHuman v1.5, handledning för talande huvud och flerspråkig guide.
Redo att prova OmniHuman v1.5? Börja skapa gratis →
Prova OmniHuman v1.5 - Just nu
Ladda upp ditt referensfoto på skapa-sidan.
5 gratis generationer · Inget kreditkort krävs