AI-lipsynchronisatie met OmniHuman v1.5: audio-gestuurde avatars
Een technische verdieping in de lipsynchronisatietechnologie van OmniHuman v1.5. Leer hoe foneemextractie, viseme-mapping en temporele uitlijning samenwerken om framenauwkeurige lipsync te creëren voor AI-avatarvideo's.
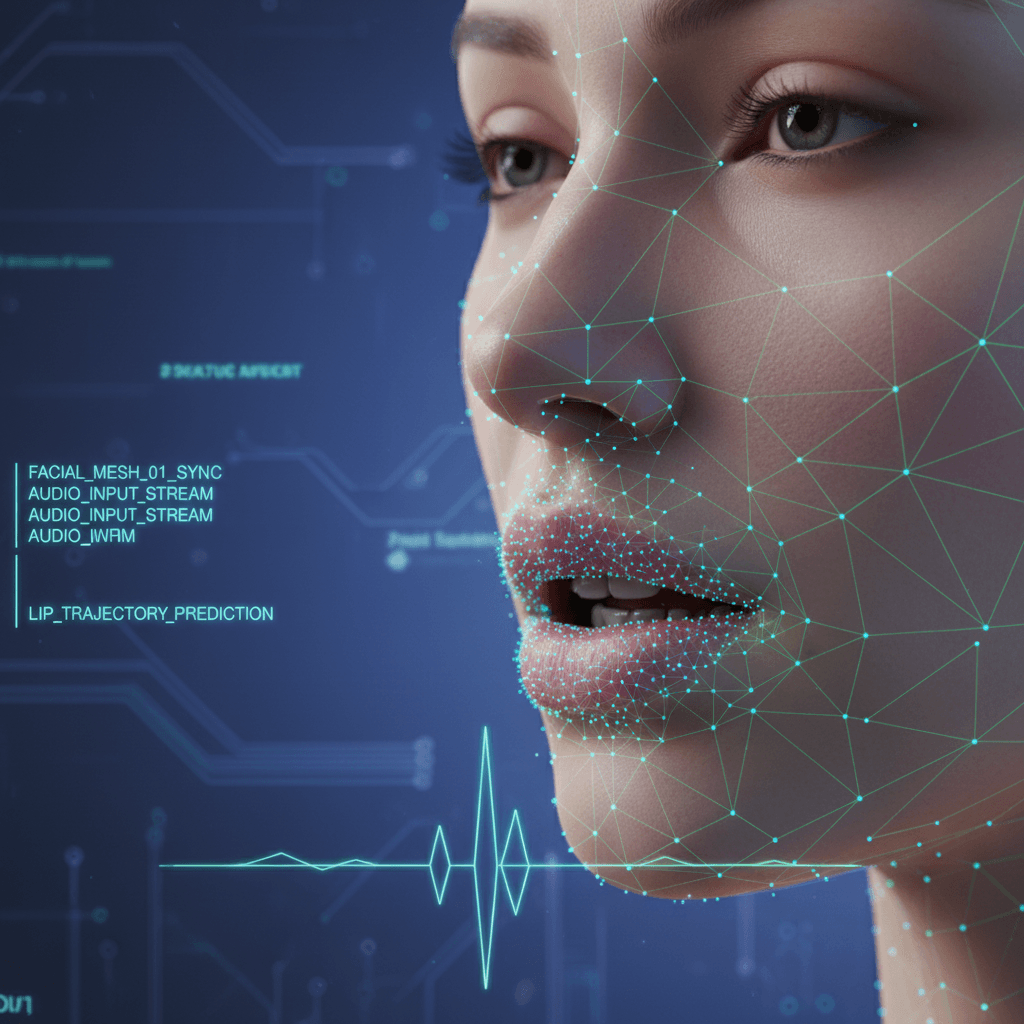
De meeste AI-avatars zakken binnen drie seconden voor de lipsynctest: monden gaan ruwweg open en dicht op het ritme van het geluid, maar de specifieke vormen komen niet overeen met de werkelijk uitgesproken klanken. OmniHuman v1.5 dicht die kloof door fonemen, de kleinste eenheden van spraak, te koppelen aan precieze mondvormen op elk afzonderlijk frame. Zo krijg je lipsync die standhoudt wanneer kijkers van dichtbij meekijken met het geluid aan.
TL;DR
- OmniHuman v1.5 gebruikt lipsync op foneem-niveau, niet alleen tijdgestuurde mondanimatie
- Het model extraheert spraakklanken uit je audio en koppelt deze aan visemen (mondvormen)
- Schone audio-invoer verbetert de synchronisatienauwkeurigheid aanzienlijk
- Een lipsync-video van 30 seconden kost $7,20 (72 credits) op abonnementen vanaf $5 per maand
- Werkt in elke gesproken taal die goed vertegenwoordigd is in de trainingsdata
Waarom de meeste AI-lipsync tekortschiet
Traditionele avatartools nemen doorgaans een van twee shortcuts:
Animatie op basis van timing. De mond gaat open en dicht op basis van audiovolumepieken. Luide momenten = open mond, stille momenten = gesloten mond. Dit ziet er van een afstand acceptabel uit, maar valt bij nauwkeurig kijken onmiddellijk door de mand, omdat de specifieke vormen niet kloppen.
Vaste visemcycli. Een kleine bibliotheek generieke mondvormen loopt in een lus als reactie op brede spraakcategorieën. Dit is beter dan puur volumegestuurde animatie, maar mist nog steeds de subtiele verschillen tussen vergelijkbare klanken.
In beide gevallen is het resultaat de "uncanny valley van mondbeweging": iets dat bijna echt lijkt, maar voor ieder die goed oplet duidelijk synthetisch is.
Maak nu je AI-presentator
Verander één foto en audio in een levensechte pratende video. $7,20 per video van 30 seconden op abonnementen vanaf $5 per maand.
Probeer OmniHuman gratis5 gratis generaties · Geen creditcard nodig
Wat OmniHuman v1.5 anders doet
OmniHuman v1.5 behandelt lipsync als een gestructureerd spraak-naar-vorm-koppelprobleem. De pipeline verloopt in vier fasen.
Fase 1: Foneem-extractie
Je audio wordt verwerkt door een akoestisch model dat individuele fonemen identificeert, de kleinste eenheden van onderscheidend geluid in gesproken taal. Engels heeft ongeveer 44 fonemen. Spaans heeft er circa 24. Mandarijn heeft weer een andere set. Het model herkent fonemen met een tijdnauwkeurigheid tot op de milliseconde.
Fase 2: Visem-koppeling
Elk foneem wordt gekoppeld aan een of meer visemen, visueel onderscheidbare mondvormen. Een viseem voor "/p/" toont lipspanning vóór de loslating. Een viseem voor "/f/" toont de boventanden op de onderlip. Een viseem voor "/o/" toont een afgeronde open mond. De koppeling van fonemen aan visemen is taalbewust en houdt rekening met de context.
Fase 3: Temporele uitlijning
Visemen worden uitgelijnd op specifieke videoframes op basis van fonemtiming. Bij 30 frames per seconde krijgt elk frame de mondvorm die overeenkomt met het exacte stukje audio dat het vertegenwoordigt. Overgangen tussen visemen worden vloeiend gemaakt om schokkerige mondbewegingen te voorkomen.
Fase 4: Diffusie-rendering
De laatste renderfase genereert de werkelijke pixels, waarbij de viseminformatie wordt gecombineerd met identiteitskenmerken van de referentiefoto, door prosodie aangestuurde gezichtsuitdrukkingen en de scèneprompt. De mond wordt niet "opgeplakt", maar gegenereerd als onderdeel van elk frame.
Waarom dit voor kijkers uitmaakt
Dit is hoe lipsync op foneem-niveau er in de praktijk uitziet wanneer je op specifieke klanken let.
Ploosieven (p, b, t, d, k, g): Lip- of tongspanning vóór de klank, dan loslating. OmniHuman toont de afsluiting duidelijk.
Fricatieven (f, v, s, z, sh, th): Lucht die door een vernauwingspunt stroomt. "F" en "V" vereisen boventanden op de onderlip, wat OmniHuman nauwkeurig reproduceert.
Klinkers (a, e, i, o, u): Verschillende graden van kaakopening en liprondheid. "Oh" en "Ah" zien er duidelijk anders uit, zoals ze zouden moeten.
Diftongen (oi, ou, ei): Glijdende overgangen tussen twee klinkervormen. Het model rendert de beweging vloeiend over de frames.
Nasalen (m, n, ng): Gesloten of bijna gesloten mond met luchtstroom door de neus. Het subtiele verschil tussen "m" (lippen gesloten) en "n" (tong naar het alveolaire richel) is zichtbaar door een lichte kaakpositie.
Wanneer dit allemaal correct wordt afgehandeld, valt de lipsync je helemaal niet meer op. Dat is het doel: onzichtbaarheid.
Hoe je de beste lipsync bereikt
De kwaliteit van je audio-invoer is de grootste bepalende factor voor de nauwkeurigheid van de lipsync. Zo optimaliseer je dit.
Gebruik schone, geïsoleerde spraak
Muziek, achtergrondgesprekken, zwaar omgevingslawaai en kamerhall verstoren allemaal de foneem-extractie. Voordat je audio uploadt:
- Verwijder of dim muziek of geluidseffecten
- Neem op in een stille ruimte of gebruik een noise gate
- Vermijd ruimtes met sterke echo
- Verwerk geen effecten zoals zware compressie of EQ in de audio
Streef naar professionele opnamekwaliteit
Je hebt geen broadcast-studio nodig, maar een USB-condensatormicrofoon in een stille kamer verslaat altijd een laptopmicrofoon. Doelspecificaties:
- Sample rate van 44,1 kHz of 48 kHz
- Bitdiepte van 16 bit of 24 bit
- Mono of stereo zijn beide acceptabel
- Piekvolumes rond -3 dB, zonder clipping
Spreek in een natuurlijk tempo
Gehaaste of monotone spraak produceert minder overtuigende lipsync dan een natuurlijke, gevarieerde uitvoering. Spreek zoals je in een echte conversatie zou doen, met natuurlijke pauzes en nadruk.
Knip leidende en afsluitende stilte weg
OmniHuman genereert video voor de volledige audioduur. Als je audio begint met 3 seconden stilte, verspil je frames. Knip strak bij.
Blijf binnen de duurlimieten
OmniHuman v1.5 ondersteunt tot 60 seconden op 720p en 30 seconden op 1080p. Clips die de limiet naderen, kunnen soms kwaliteitsverlies vertonen in de laatste frames. Streef naar een seconde of twee onder de limiet.
Klaar om OmniHuman v1.5 te proberen? Gratis beginnen met maken →

Wil je een presentator zoals deze? OmniHuman gratis proberen →
Taalspecifieke overwegingen
Foneemsets verschillen per taal, en de nauwkeurigheid van het model varieert met de representatie in de trainingsdata.
Breed getrainde talen
Engels, Mandarijn, Spaans, Portugees, Frans, Duits, Japans en Koreaans ontvangen allemaal hoognauwkeurige lipsync. Deze talen beschikken over robuuste trainingsdata, en fonemen worden met precisie op frameniveau gekoppeld aan visemen.
Goed ondersteunde talen
Italiaans, Russisch, Arabisch, Hindi, Indonesisch, Vietnamees en Turks werken betrouwbaar met sterke lipsync-kwaliteit. Kleine variaties in regionale accenten kunnen bepaalde fonemen iets beïnvloeden.
Opkomende taalondersteuning
Minder gangbare talen werken, maar de nauwkeurigheid voor zeldzame fonemen kan lager zijn. Test met een korte sample voordat je je committeert aan een grote productie.
Zie voor meertalige projecten de meertalige gids voor stemadviezen en lokalisatieworkflows.
Veelvoorkomende lipsyncproblemen en oplossingen
Mondbewegingen voelen licht vertraagd aan
Oorzaak: Het audiobestand heeft stille opvulling aan het begin, of compressieartefacten hebben de fonemtiming verschoven. Oplossing: Knip de leidende stilte weg en exporteer opnieuw op een hogere bitrate (MP3 192 kbps of hoger, of WAV).
Mondvormen zien er te generiek uit
Oorzaak: Audio is ruizig of troebel, wat de foneem-extractie belemmert. Oplossing: Neem opnieuw op in een stillere ruimte, of verwerk de audio met een ruisonderdrukkingstool.
Sync werkt voor klinkers, maar medeklinkers zien er vaag uit
Oorzaak: Slechte microfooon of zware compressie die de transiënten van medeklinkers verzacht. Oplossing: Gebruik een betere microfoon, verminder compressie, of gebruik TTS dat schonere medeklinkers produceert.
Lipsync hapert bij bepaalde accenten
Oorzaak: Regionale accentvarianten van fonemen kunnen ondervertegenwoordigd zijn in de trainingsdata. Oplossing: Probeer een neutraal accent voor dezelfde taal, of gebruik professionele TTS met selecteerbare regionale stemmen.
Sync drijft af bij langere clips
Oorzaak: Audio- en videokloktiming raken aan het einde van de duur uit synchronisatie. Oplossing: Blijf een seconde of twee onder de duurlimiet. Splits langere inhoud op in segmenten.
Lipsync-kwaliteit testen
Test met een korte sample voordat je je committeert aan een lange productiereeks.
De 10-secondentest
- Neem een audioclip van 10 seconden op met deze exacte zin: "Peter picked pepper, five fish fried, shy shepherds sigh."
- Upload dit samen met je gekozen referentiefoto naar OmniHuman v1.5
- Genereer en speel af op 100% formaat
- Let op:
- Duidelijke lipsluiting bij "P"-klanken
- Boventanden op de onderlip bij "F"
- Verschillende mondvormen voor "sh" en "s"
- Vloeiende overgangen tussen fonemen
Als de 10-secondentest er goed uitziet, ziet de productie van 30-60 seconden er ook goed uit.
Vergelijking naast elkaar
Speel de OmniHuman-output naast je referentieaudio af via een koptelefoon. Doe je ogen dicht en open ze dan weer. Als de mondbewegingen "duidelijk" aanvoelen wanneer je je opnieuw op de video focust, werkt de sync. Als ze "verkeerd" aanvoelen, vereist iets in de audiopipeline aandacht.
Hoe lipsync past in de volledige generatiepipeline
Lipsync is een van de meerdere parallelle systemen die tijdens OmniHuman-generatie draaien. De volledige pipeline omvat:
- Identiteitsbehoud op basis van de referentiefoto
- Gezichtsuitdrukking aangedreven door audio-emotie en prosodie
- Hoofdbeweging die correleert met het spreekritme
- Schouder- en bovenlichaamsgebaren gesynchroniseerd met nadruk
- Achtergrond- en scènerendering op basis van je prompt
- Temporele coherentie over frames heen
Lipsync bestaat niet op zichzelf: het is één laag van een groter generatief systeem. Wanneer alles samenwerkt, zien kijkers een natuurlijke opname in plaats van een pratend hoofd met goede mondbewegingen.
Zie de volledige OmniHuman v1.5-gids voor het volledige technische overzicht.
Foneem-nauwkeurige sync, $7,20 voor 30 seconden
Geen kwaliteitsniveaus voor sync en geen prijzen per gebruiker. Één prijs per video, en je maandelijkse credits worden elke factuurcyclus vernieuwd.
Test de syncKosten en toegang
Elke OmniHuman v1.5-generatie, inclusief lipsync, kost 3-72 credits ($0,30-$7,20), wat de lengte van je audio bijhoudt: 2,4 credits per seconde. Geen lipsync-toeslag, geen gelaagde synckwaliteit. Je krijgt dezelfde foneem-nauwkeurigheid bij elke render.
Nieuwe Arteza-accounts ontvangen 10 gratis credits bij aanmelding. Het Starter-abonnement van $5 geeft je 60 credits per maand, genoeg voor één generatie van dertig seconden plus verkenning. Zie de prijzengids voor alle details.
Begin met het testen van lipsync-kwaliteit
- Aanmelden bij Arteza en claim 10 gratis credits
- Abonneer je op het Starter-abonnement van $5
- Bereid een korte tongue-twister-audioclip en een portretfoto voor
- Open OmniHuman v1.5
- Genereer en evalueer
Voor meer context, zie de volledige OmniHuman v1.5-gids, de tutorial voor pratende hoofden en de meertalige gids.
Klaar om OmniHuman v1.5 te proberen? Gratis beginnen met maken →
OmniHuman v1.5 uitproberen - Nu!
Upload je referentieafbeelding op de aanmaakpagina.
5 gratis generaties · Geen creditcard nodig