Sincronización labial con IA en OmniHuman v1.5: avatares guiados por audio
Un análisis técnico en profundidad de la tecnología de sincronización labial de OmniHuman v1.5. Aprende cómo la extracción de fonemas, el mapeo de visemas y la alineación temporal trabajan juntos para crear una sincronización labial cuadro a cuadro en videos de avatares con IA.
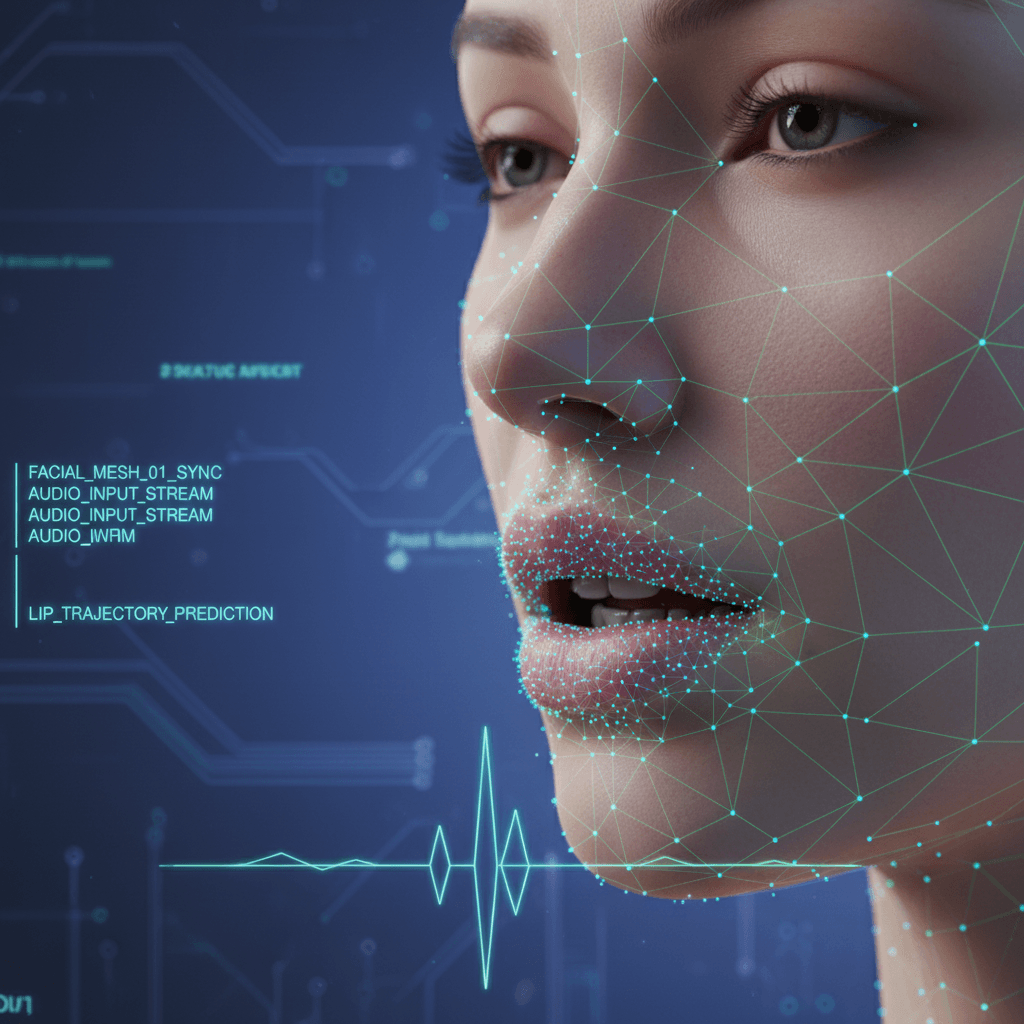
La mayoría de los avatares de IA no superan la prueba de sincronización labial en los primeros tres segundos: la boca se abre y se cierra más o menos al ritmo del audio, pero las formas específicas no coinciden con los sonidos que se están pronunciando. OmniHuman v1.5 cierra esa brecha mapeando fonemas, las unidades atómicas del habla, a configuraciones precisas de la boca en cada fotograma. Así se consigue una sincronización labial que aguanta incluso cuando los espectadores miran de cerca con el sonido activado.
Resumen rápido
- OmniHuman v1.5 usa sincronización labial a nivel de fonemas, no solo animación de boca basada en el tiempo
- El modelo extrae los sonidos del habla de tu audio y los mapea a visemas (formas de la boca)
- Un audio limpio mejora drásticamente la precisión de la sincronización
- Un vídeo de 30 segundos con sincronización labial cuesta $7.20 (72 créditos) en planes desde $5 al mes
- Funciona en cualquier idioma hablado con buena representación en el entrenamiento
Por qué la mayoría de las sincronizaciones labiales de IA se quedan cortas
Las herramientas de avatar tradicionales suelen tomar uno de estos dos atajos:
Animación solo por tiempo. La boca se abre y se cierra según los picos de volumen del audio. Momentos fuertes = boca abierta, momentos silenciosos = boca cerrada. Puede parecer aceptable desde lejos, pero falla de inmediato al verlo de cerca porque las formas específicas son incorrectas.
Ciclo fijo de visemas. Una pequeña biblioteca de formas de boca genéricas se repite en respuesta a categorías amplias del habla. Es mejor que la animación basada puramente en volumen, pero sigue pasando por alto las sutiles diferencias entre sonidos similares.
El resultado en ambos casos es el "valle inquietante del movimiento de la boca": algo que parece casi real, pero claramente sintético para quien presta atención.
Crea tu presentador con IA ahora
Convierte una foto y un audio en un vídeo hablado hiperrealista. $7.20 por vídeo de 30 segundos en planes desde $5 al mes.
Probar OmniHuman gratis5 generaciones gratis · Sin tarjeta de crédito
Qué hace diferente a OmniHuman v1.5
OmniHuman v1.5 trata la sincronización labial como un problema de mapeo estructurado de habla a forma. El proceso se ejecuta en cuatro etapas.
Etapa 1: extracción de fonemas
Tu audio pasa por un modelo acústico que identifica fonemas individuales, las unidades más pequeñas de sonido diferenciado en el lenguaje hablado. El inglés tiene alrededor de 44 fonemas. El español tiene unos 24. El mandarín tiene otro conjunto distinto. El modelo reconoce fonemas con una precisión temporal de milisegundos.
Etapa 2: mapeo de visemas
Cada fonema se mapea a uno o más visemas, formas de boca visualmente distintas. Un visema para "/p/" muestra el cierre de los labios antes de la apertura. Un visema para "/f/" muestra los dientes superiores sobre el labio inferior. Un visema para "/o/" muestra la boca abierta y redondeada. El mapeo de fonema a visema tiene en cuenta el idioma y el contexto.
Etapa 3: alineación temporal
Los visemas se alinean con fotogramas de vídeo específicos según el tiempo de cada fonema. A 30 fotogramas por segundo, cada fotograma recibe la forma de boca que corresponde al fragmento exacto de audio que representa. Las transiciones entre visemas se suavizan para evitar movimientos de boca entrecortados.
Etapa 4: renderizado por difusión
La etapa final de renderizado genera los píxeles reales, incorporando la información de los visemas junto con las características de identidad de la foto de referencia, la expresión facial basada en la prosodia y el prompt de escena. La boca no se "pega encima": se genera como parte de cada fotograma.
Por qué esto importa para los espectadores
Así es como se ve la sincronización labial a nivel de fonemas en la práctica cuando prestas atención a sonidos específicos.
Oclusivas (p, b, t, d, k, g): cierre de labios o lengua antes del sonido y luego apertura. OmniHuman muestra el cierre con claridad.
Fricativas (f, v, s, z, sh, th): aire fluyendo a través de un punto de constricción. "F" y "V" requieren los dientes superiores sobre el labio inferior, lo que OmniHuman reproduce con precisión.
Vocales (a, e, i, o, u): distintos grados de apertura de mandíbula y redondeamiento de labios. "O" y "A" tienen formas claramente diferentes, como debe ser.
Diptongos (oi, ou, ay): transiciones deslizantes entre dos formas vocálicas. El modelo renderiza el movimiento de forma fluida a lo largo de los fotogramas.
Nasales (m, n, ng): boca cerrada o casi cerrada con el flujo de aire por la nariz. La sutil diferencia entre "m" (labios cerrados) y "n" (lengua en el reborde alveolar) se aprecia en el posicionamiento leve de la mandíbula.
Cuando todo esto se gestiona correctamente, dejas de notar la sincronización labial. Ese es el objetivo: la invisibilidad.
Cómo obtener la mejor sincronización labial
La calidad del audio de entrada es el factor más importante en la precisión de la sincronización labial. Así es como optimizarla.
Usa habla limpia y aislada
La música, el ruido de fondo, el ruido ambiente intenso y la reverberación de la sala interfieren con la extracción de fonemas. Antes de subir el audio:
- Elimina o baja el volumen de cualquier música o efecto de sonido
- Graba en una habitación silenciosa o usa un gate de ruido
- Evita habitaciones con eco fuerte
- No apliques efectos como compresión intensa o ecualización
Busca una calidad de grabación profesional
No necesitas un estudio de emisión, pero un micrófono de condensador USB en una habitación tranquila supera siempre a un micrófono de portátil. Especificaciones recomendadas:
- Frecuencia de muestreo de 44,1 kHz o 48 kHz
- Profundidad de 16 bits o 24 bits
- Mono o estéreo, ambos son válidos
- Niveles de pico en torno a -3 dB, sin recorte
Habla a un ritmo natural
Un habla apresurada o monótona produce una sincronización labial menos convincente que una entrega natural y variada. Habla como lo harías en una conversación real, con pausas naturales y énfasis.
Recorta los silencios iniciales y finales
OmniHuman genera vídeo durante toda la duración del audio. Si tu audio empieza con 3 segundos de silencio, desperdicias fotogramas. Recorta con precisión.
Respeta los límites de duración
OmniHuman v1.5 admite hasta 60 segundos a 720p y 30 segundos a 1080p. Los clips cercanos al límite a veces presentan caídas de calidad en los últimos fotogramas. Apunta a quedarte uno o dos segundos por debajo del límite.
¿Listo para probar OmniHuman v1.5? Empieza a crear gratis →

¿Quieres un presentador así? Prueba OmniHuman gratis →
Consideraciones específicas por idioma
Los conjuntos de fonemas varían entre idiomas, y la precisión del modelo depende de la representación en los datos de entrenamiento.
Idiomas con amplio entrenamiento
El inglés, el mandarín, el español, el portugués, el francés, el alemán, el japonés y el coreano reciben sincronización labial de alta precisión. Estos idiomas cuentan con datos de entrenamiento sólidos, y los fonemas se mapean a visemas con precisión de fotograma.
Idiomas bien soportados
El italiano, el ruso, el árabe, el hindi, el indonesio, el vietnamita y el turco funcionan de manera fiable con buena calidad de sincronización labial. Las variaciones en acentos regionales pueden afectar ligeramente a fonemas concretos.
Soporte para idiomas emergentes
Los idiomas menos comunes funcionan, pero la precisión en fonemas poco frecuentes puede ser menor. Realiza una prueba con una muestra corta antes de comprometerte con una producción de gran envergadura.
Para proyectos en varios idiomas, consulta el guía multilingüe para recomendaciones de voz y flujos de trabajo de localización.
Problemas comunes de sincronización labial y cómo solucionarlos
Los movimientos de la boca parecen ligeramente retrasados
Causa: El archivo de audio tiene silencio al inicio, o los artefactos de compresión han desplazado el tiempo de los fonemas. Solución: Recorta el silencio inicial y vuelve a exportar a un bitrate más alto (MP3 a 192 kbps o superior, o WAV).
Las formas de la boca parecen demasiado genéricas
Causa: El audio es ruidoso o empastado, lo que perjudica la extracción de fonemas. Solución: Vuelve a grabar en un espacio más silencioso o pasa el audio por una herramienta de reducción de ruido.
La sincronización funciona con las vocales pero las consonantes se ven borrosas
Causa: Micrófono de baja calidad o compresión excesiva que suaviza los transitorios de las consonantes. Solución: Usa un micrófono mejor, reduce la compresión o utiliza TTS, que produce consonantes más limpias.
La sincronización labial falla con ciertos acentos
Causa: Las variantes fonéticas del acento regional pueden estar infrarepresentadas en los datos de entrenamiento. Solución: Prueba con una voz de acento neutro para el mismo idioma, o usa TTS de calidad profesional con voces regionales seleccionables.
La sincronización se desplaza en clips más largos
Causa: El reloj de audio y el reloj de vídeo se desalinean en el extremo de la duración. Solución: Quédate uno o dos segundos por debajo del límite de duración. Divide el contenido más largo en segmentos.
Cómo evaluar la calidad de la sincronización labial
Antes de comprometerte con una producción larga, prueba con una muestra corta.
La prueba de los 10 segundos
- Graba un clip de audio de 10 segundos con esta frase exacta: "Peter picked pepper, five fish fried, shy shepherds sigh."
- Súbela junto con la foto de referencia elegida a OmniHuman v1.5
- Genera el vídeo y reprodúcelo al 100% de tamaño
- Observa:
- Cierre claro de labios en los sonidos "P"
- Dientes superiores sobre el labio inferior para "F"
- Formas de boca diferentes para "sh" y "s"
- Transiciones limpias entre fonemas
Si la prueba de 10 segundos se ve limpia, la producción de 30-60 segundos también se verá limpia.
Comparación en paralelo
Reproduce la salida de OmniHuman junto a tu audio de referencia con auriculares. Cierra los ojos y luego ábrelos. Si los movimientos de la boca se sienten "evidentes" cuando vuelves a enfocar el vídeo, la sincronización funciona. Si se sienten "incorrectos", algo en el proceso de audio necesita atención.
Cómo encaja la sincronización labial en el proceso completo de generación
La sincronización labial es uno de los varios sistemas paralelos que se ejecutan durante la generación en OmniHuman. El proceso completo incluye:
- Preservación de la identidad a partir de la foto de referencia
- Expresión facial guiada por la emoción y la prosodia del audio
- Movimiento de cabeza que se correlaciona con el ritmo del habla
- Gestos de hombros y parte superior del cuerpo sincronizados con el énfasis
- Fondo y renderizado de escena según tu prompt
- Coherencia temporal entre fotogramas
La sincronización labial no existe de forma aislada: es una capa más dentro de un sistema generativo más amplio. Cuando todo funciona en conjunto, los espectadores ven una grabación natural en lugar de una cabeza parlante con buen movimiento de boca.
Para el resumen técnico completo, consulta el guía completa de OmniHuman v1.5.
Sincronización precisa a nivel de fonemas, $7.20 por 30 segundos
Sin niveles de calidad de sincronización y sin precios por puesto. Un precio por vídeo, y tus créditos mensuales se renuevan en cada ciclo de facturación.
Probar la sincronizaciónCoste y acceso
Cada generación de OmniHuman v1.5, incluida la sincronización labial, cuesta 3-72 créditos ($0,30-$7,20), lo que se corresponde con la duración de tu audio: 2,4 créditos por segundo. Sin recargo por sincronización labial, sin niveles de calidad. Obtienes la misma precisión a nivel de fonemas en cada renderizado.
Las cuentas nuevas de Arteza reciben 10 créditos gratis al registrarse. El plan Starter de $5 incluye 60 créditos al mes, suficientes para una generación de treinta segundos más exploración. Consulta el guía de precios para todos los detalles.
Empieza a evaluar la calidad de la sincronización labial
- Regístrate en Arteza y obtén 10 créditos gratis
- Suscríbete al plan Starter de $5
- Prepara un clip de audio corto con un trabalenguas y una foto de retrato
- Abre OmniHuman v1.5
- Genera y evalúa
Para más contexto, consulta el guía completa de OmniHuman v1.5, el tutorial de cabeza parlante y el guía multilingüe.
¿Listo para probar OmniHuman v1.5? Empieza a crear gratis →
Prueba OmniHuman v1.5 - ¡Ahora mismo!
Sube tu imagen de referencia en la página de creación.
5 generaciones gratis · Sin tarjeta de crédito