Sincronização labial com IA no OmniHuman v1.5: avatares guiados por áudio
Uma análise técnica aprofundada da tecnologia de sincronização labial do OmniHuman v1.5. Aprenda como a extração de fonemas, o mapeamento de visemas e o alinhamento temporal trabalham juntos para criar sincronização labial quadro a quadro em vídeos de avatares com IA.
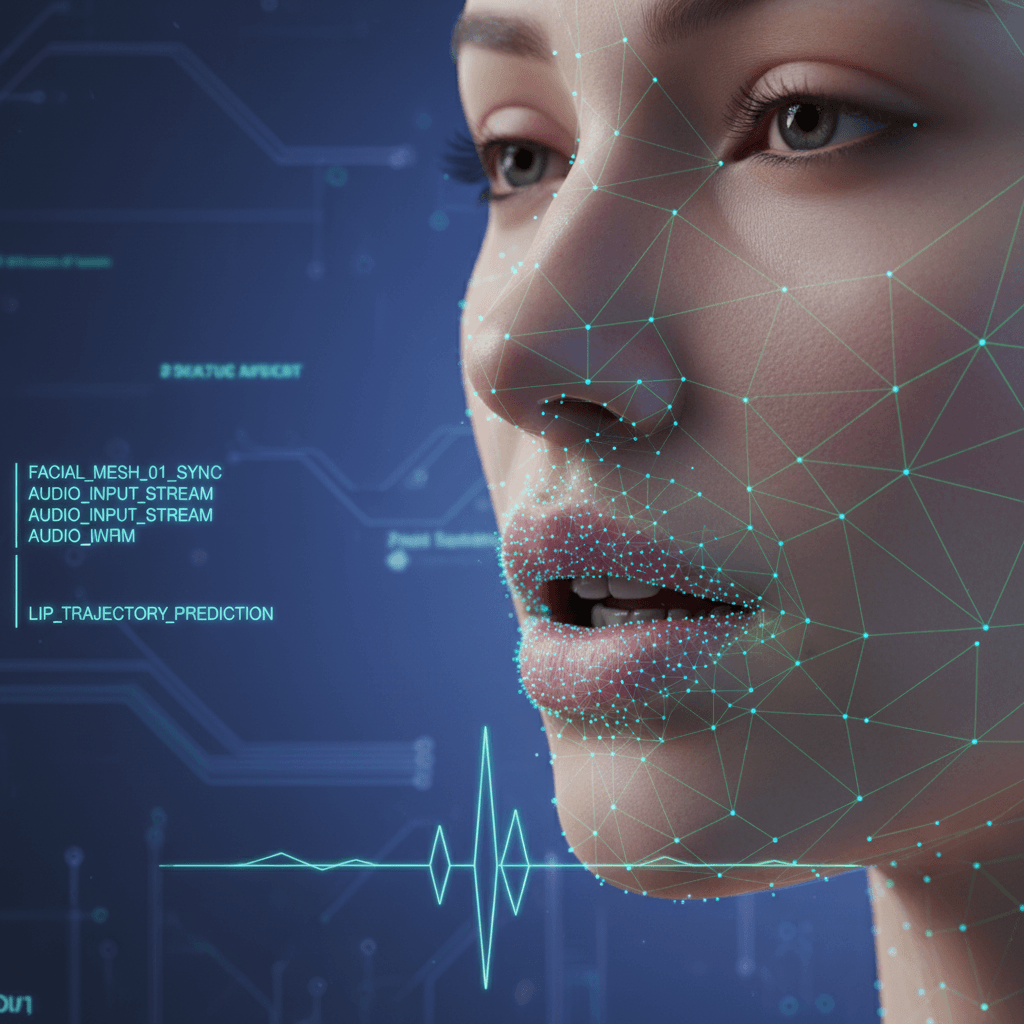
A maioria dos avatares de IA falha no teste de sincronia labial em três segundos: as bocas abrem e fecham mais ou menos no ritmo do áudio, mas as formas específicas não correspondem aos sons pronunciados. O OmniHuman v1.5 fecha essa lacuna mapeando fonemas, as unidades atômicas da fala, para configurações bucais precisas em cada frame. É assim que se obtém uma sincronia labial que resiste ao escrutínio quando os espectadores assistem de perto com o som ligado.
Resumo rápido
- O OmniHuman v1.5 usa sincronia labial em nível de fonema, não apenas animação bucal baseada em tempo
- O modelo extrai sons da fala do seu áudio e os mapeia para visemas (formas bucais)
- Um áudio limpo melhora drasticamente a precisão da sincronia
- Um vídeo de 30 segundos com sincronia labial custa $7,20 (72 créditos) nos planos a partir de $5 por mês
- Funciona com qualquer idioma que tenha boa representação nos dados de treinamento
Por que a maioria das sincronias labiais de IA fica a desejar
As ferramentas de avatar tradicionais costumam adotar um destes dois atalhos:
Animação apenas pelo tempo. A boca abre e fecha com base nos picos de volume do áudio. Momentos altos = boca aberta, momentos silenciosos = boca fechada. Parece aceitável de longe, mas falha imediatamente em close porque as formas específicas estão erradas.
Ciclo fixo de visemas. Uma pequena biblioteca de formas bucais genéricas é executada em loop em resposta a categorias amplas de fala. É melhor do que a animação puramente baseada em volume, mas ainda perde as distinções sutis entre sons semelhantes.
O resultado em ambos os casos é o "vale da estranheza do movimento bucal": algo que parece quase real, mas claramente sintético para quem está prestando atenção.
Crie seu apresentador de IA agora
Transforme uma foto + áudio em um vídeo falante realista. $7,20 por vídeo de 30 segundos nos planos a partir de $5 por mês.
Experimente o OmniHuman grátis5 gerações gratuitas · Nenhum cartão de crédito necessário
O que o OmniHuman v1.5 faz de diferente
O OmniHuman v1.5 trata a sincronia labial como um problema estruturado de mapeamento de fala para forma. O pipeline opera em quatro etapas.
Etapa 1: extração de fonemas
O áudio passa por um modelo acústico que identifica fonemas individuais, as menores unidades de som distintas na linguagem falada. O inglês tem cerca de 44 fonemas. O espanhol tem aproximadamente 24. O mandarim possui um conjunto diferente. O modelo reconhece fonemas com precisão de tempo em milissegundos.
Etapa 2: mapeamento de visemas
Cada fonema é mapeado para um ou mais visemas, formas bucais visualmente distintas. Um visema para "/p/" mostra o fechamento dos lábios antes da soltura. Um visema para "/f/" mostra os dentes superiores sobre o lábio inferior. Um visema para "/o/" mostra a boca arredondada e aberta. O mapeamento fonema-visema leva em conta o idioma e considera o contexto.
Etapa 3: alinhamento temporal
Os visemas são alinhados a frames de vídeo específicos com base no tempo dos fonemas. A 30 frames por segundo, cada frame recebe a forma bucal que corresponde ao trecho exato do áudio que representa. As transições entre visemas são suavizadas para evitar movimentos bucais instáveis.
Etapa 4: renderização por difusão
A etapa final de renderização gera os pixels reais, incorporando as informações dos visemas junto com as características de identidade da foto de referência, a expressão facial guiada pela prosódia e o prompt de cena. A boca não é "colada": ela é gerada como parte de cada frame.
Por que isso importa para os espectadores
Veja como a sincronia labial em nível de fonema se manifesta na prática quando você presta atenção nos sons específicos.
Plosivas (p, b, t, d, k, g): fechamento dos lábios ou da língua antes do som, depois a soltura. O OmniHuman mostra o fechamento com clareza.
Fricativas (f, v, s, z, sh, th): ar fluindo por um ponto constricionado. "F" e "V" exigem os dentes superiores sobre o lábio inferior, o que o OmniHuman reproduz com precisão.
Vogais (a, e, i, o, u): diferentes graus de abertura da mandíbula e arredondamento dos lábios. "Oh" e "Ah" parecem distintos, como deveriam.
Ditongos (oi, ou, ai): transições deslizantes entre duas formas vocálicas. O modelo renderiza o movimento de forma fluida entre os frames.
Nasais (m, n, ng): boca fechada ou quase fechada com fluxo de ar pelo nariz. A diferença sutil entre "m" (lábios fechados) e "n" (língua no alvéolo) aparece por meio do posicionamento leve da mandíbula.
Quando tudo isso é tratado corretamente, você para de notar a sincronia labial. Esse é o objetivo: a invisibilidade.
Como obter a melhor sincronia labial
A qualidade do áudio de entrada é o fator mais importante na precisão da sincronia labial. Veja como otimizá-la.
Use fala limpa e isolada
Músicas, barulhos de fundo, ruído ambiente intenso e reverberação interferem na extração de fonemas. Antes de fazer o upload do áudio:
- Remova ou reduza qualquer música ou efeito sonoro
- Grave em um ambiente silencioso ou use um noise gate
- Evite ambientes com eco forte
- Não aplique efeitos como compressão pesada ou equalização excessiva
Busque qualidade de gravação profissional
Não é necessário um estúdio de transmissão, mas um microfone condensador USB em um quarto silencioso supera um microfone de laptop sempre. Especificações recomendadas:
- Taxa de amostragem de 44,1 kHz ou 48 kHz
- Profundidade de 16 bits ou 24 bits
- Mono ou estéreo, ambos aceitáveis
- Níveis de pico em torno de -3 dB, sem clipping
Fale em um ritmo natural
Uma fala apressada ou monótona produz sincronia labial menos convincente do que uma entrega natural e variada. Fale como falaria em uma conversa real, com pausas naturais e ênfase.
Corte silêncios no início e no fim
O OmniHuman gera vídeo para toda a duração do áudio. Se o áudio começa com 3 segundos de silêncio, você desperdiça frames. Corte com precisão.
Respeite os limites de duração
O OmniHuman v1.5 suporta até 60 segundos em 720p e 30 segundos em 1080p. Clipes próximos ao limite às vezes apresentam quedas de qualidade nos últimos frames. Mantenha-se um ou dois segundos abaixo do limite.
Pronto para experimentar o OmniHuman v1.5? Comece a criar gratuitamente →

Quer um apresentador assim? Experimente o OmniHuman gratuitamente →
Considerações por idioma
Os conjuntos de fonemas variam entre os idiomas, e a precisão do modelo varia conforme a representação nos dados de treinamento.
Idiomas com amplo treinamento
Inglês, mandarim, espanhol, português, francês, alemão, japonês e coreano recebem sincronia labial de alta precisão. Esses idiomas têm dados de treinamento robustos, e os fonemas são mapeados para visemas com precisão em nível de frame.
Idiomas bem suportados
Italiano, russo, árabe, hindi, indonésio, vietnamita e turco funcionam de forma confiável com boa qualidade de sincronia labial. Variações de sotaque regional podem afetar levemente certos fonemas.
Suporte a idiomas emergentes
Idiomas menos comuns funcionam, mas a precisão em fonemas raros pode ser menor. Teste com uma amostra curta antes de se comprometer com uma produção grande.
Para projetos em múltiplos idiomas, consulte guia multilíngue para recomendações de voz e fluxos de localização.
Problemas comuns de sincronia labial e como resolvê-los
Os movimentos bucais parecem levemente atrasados
Causa: o arquivo de áudio tem silêncio no início ou artefatos de compressão deslocaram o tempo dos fonemas. Solução: corte o silêncio inicial e reexporte com bitrate mais alto (MP3 192 kbps ou superior, ou WAV).
As formas bucais parecem genéricas demais
Causa: o áudio está com ruído ou turvo, prejudicando a extração de fonemas. Solução: regrave em um ambiente mais silencioso ou passe o áudio por uma ferramenta de redução de ruído.
A sincronia funciona nas vogais, mas as consoantes parecem fracas
Causa: microfone de baixa qualidade ou compressão pesada suavizando os transientes das consoantes. Solução: use um microfone melhor, reduza a compressão ou utilize TTS, que produz consoantes mais nítidas.
A sincronia labial falha em certos sotaques
Causa: variantes fonéticas de sotaque regional podem estar sub-representadas nos dados de treinamento. Solução: tente uma voz com sotaque neutro para o mesmo idioma ou use TTS de qualidade profissional com vozes regionais selecionáveis.
A sincronia deriva em clipes mais longos
Causa: o clock de áudio e o clock de vídeo saem de alinhamento na extremidade da duração. Solução: mantenha-se um ou dois segundos abaixo do limite de duração. Divida conteúdos mais longos em segmentos.
Testando a qualidade da sincronia labial
Antes de se comprometer com uma produção longa, teste com uma amostra curta.
O teste de 10 segundos
- Grave um clipe de áudio de 10 segundos com esta frase exata: "Peter picked pepper, five fish fried, shy shepherds sigh."
- Faça o upload com a foto de referência escolhida para o OmniHuman v1.5
- Gere e reproduza em 100% do tamanho
- Observe:
- Fechamento claro dos lábios nos sons "P"
- Dentes superiores sobre o lábio inferior no "F"
- Formas bucais diferentes para "sh" e "s"
- Transições limpas entre fonemas
Se o teste de 10 segundos parecer limpo, a produção de 30 a 60 segundos também ficará.
Comparação lado a lado
Reproduza a saída do OmniHuman ao lado do seu áudio de referência com fones de ouvido. Feche os olhos e depois abra-os. Se os movimentos bucais parecerem "óbvios" quando você refocalizar o vídeo, a sincronia está funcionando. Se parecerem "errados", algo no pipeline de áudio precisa de atenção.
Como a sincronia labial se encaixa no pipeline completo de geração
A sincronia labial é um dos vários sistemas paralelos que funcionam durante a geração pelo OmniHuman. O pipeline completo inclui:
- Preservação de identidade a partir da foto de referência
- Expressão facial guiada pela emoção e prosódia do áudio
- Movimento da cabeça correlacionado com o ritmo da fala
- Gestos dos ombros e da parte superior do corpo sincronizados com a ênfase
- Renderização de fundo e cena a partir do seu prompt
- Coerência temporal entre os frames
A sincronia labial não existe de forma isolada: ela é uma camada de um sistema generativo maior. Quando tudo funciona em conjunto, os espectadores veem uma gravação natural em vez de uma cabeça falante com bom movimento bucal.
Para uma visão geral técnica completa, consulte guia completo do OmniHuman v1.5.
Sincronia precisa por fonema, $7,20 por 30 segundos
Sem níveis de qualidade de sincronia e sem preço por usuário. Um preço por vídeo, e seus créditos mensais são renovados a cada ciclo de cobrança.
Teste a sincroniaCusto e acesso
Cada geração do OmniHuman v1.5, incluindo a sincronia labial, custa 3-72 créditos ($0,30-$7,20), proporcional à duração do áudio: 2,4 créditos por segundo. Sem taxa adicional por sincronia labial e sem níveis de qualidade. Você recebe a mesma precisão em nível de fonema em cada renderização.
Novas contas na Arteza recebem 10 créditos grátis no cadastro. O plano Starter de $5 oferece 60 créditos por mês, suficientes para uma geração de trinta segundos mais exploração. Consulte guia de preços para todos os detalhes.
Comece a testar a qualidade da sincronia labial
- Cadastre-se no Arteza e reivindique 10 créditos grátis
- Assine o plano Starter de $5
- Prepare um clipe de áudio curto com trava-língua e uma foto de retrato
- Abra OmniHuman v1.5
- Gere e avalie
Para mais contexto, consulte guia completo do OmniHuman v1.5, tutorial de cabeça falante e guia multilíngue.
Pronto para experimentar o OmniHuman v1.5? Comece a criar gratuitamente →
Experimente OmniHuman v1.5 - Agora mesmo
Faça upload da sua imagem de referência na página de criação.
5 gerações gratuitas · Nenhum cartão de crédito necessário